一句话结论: 截至 2025 年初 [1],LLM 已能轻松拆掉单独使用的 CFF,但对 IS 和组合混淆仍全面失败;2026 年的 Agent 实验 [2] 进一步表明瓶颈不在模型推理力而在架构缺陷——笔者判断组合混淆的防线至今成立。混淆没有过时,只是需要换一种组合方式。
读完本文你会知道:
- AI 逆向工具链(以 REA 为例)正在如何从「聊天式辅助」进化为「Agent 驱动的专业工具链」
- 三种经典混淆(BCF / IS / CFF)分别是什么,以及 LLM 为什么对它们的抵抗力完全不同
- 8 个主流 LLM 在同一段混淆代码上的成绩单,以及它们最常犯的 5 类错误
- AI Agent 自主逆向时暴露的 3 个系统性缺陷
- 工具链如何在四维框架的每个维度上补强 LLM 的弱点
- 如何通过 Hypothesis Manager / Evidence Arbitrator / Adversarial Auditor 三机制改良 Agent 架构
- 笔者对逆向工程趋势的 4 个阶段性判断
- 作为保护方,下一步应该怎么调整混淆策略
使用的模型已达 Claude 5 级别 → 缺陷是架构问题,不因模型更强而消失
〇、摘要
2026 年,一个名为 REA 的开源项目在半年内拿到了 19 万+ Star,让 AI Agent 通过 MCP 协议直接驱动 Ghidra、Hopper、IDA——不是「把汇编贴给 LLM 猜」,而是让 Agent 拥有了逆向工程师的完整工具箱。
笔者日常做 DRM 方向的安全研究,一半时间在给保护方案加混淆,另一半时间在拆别人的混淆。面对 AI 逆向工具链的快速演进,被问得最多的问题是:混淆还有用吗?
为了不拍脑袋回答,笔者从三个维度切入:
- 工具链:剖析 REA(192K+ Star)的 MCP 架构,理解 AI 逆向的当前形态和演进方向
- 能力评估:精读 Promon 的四维框架论文 + Quarkslab 的 Agent 攻防实验,用数据回答「AI 能做到什么」和「做不到什么」
- 实战验证:结合笔者的 OLLVM 去混淆经验(见《所有分支都指向同一个 switch,然后呢》)和自研工具链(D810G 反混淆框架、Ponce4Ghidra 符号执行插件、unpack 脱壳框架、cap 中间人代理、re-agent 逆向 Agent)的开发实践,给出攻防趋势判断
本文沿「现状 → 能力 → 分析 → 行动」四条线展开:
A. 现状:AI 逆向工具链长什么样(§一 ~ §二)
- 从 REA 看工具链演进:MCP 架构如何让 Agent 驱动 Ghidra/Hopper/IDA,附行业四阶段模型
B. 能力:AI 能拆多少混淆(§三 ~ §四)
- 四维框架:用推理深度、模式识别、噪声过滤、上下文整合四个维度,解释为什么 LLM 对不同混淆的表现差别这么大
- 8 个 LLM 横向对比 + 5 类常见错误:整理论文 32 组实验结果,附典型错误输出
- Quarkslab Agent 实验的 3 个教训:让 AI 自己动手逆向时暴露的系统性缺陷
C. 分析:工具链与实战的碰撞(§五 ~ §七)
- 四维框架下的 REA 架构分析:工具链如何在每个维度上系统性补强 LLM 短板
- 实战视角:CFF 降级、IS 重估、组合混淆有效性
- 逆向工程趋势判断:分 4 个阶段预测攻防走向
D. 改良:Agent 架构如何升级(§八)
- 从趋势到实践:Hypothesis Manager / Evidence Arbitrator / Adversarial Auditor 三机制改良路线图 + 攻防共演三轮阶梯
E. 行动:攻防双方该怎么办(§九 ~ §十一)
- 一个可以动手的挑战
.so:3 层混淆 + 1 层 anti-agent 陷阱、4 个 flag,测测你自己或你的 AI 助手 - 给攻击方(Agent 使用者)的 6 条建议(A1-A6)+ 给防守方的 9 条建议(P0-P3 + D1-D3)
| 线索 | 核心问题 | 对应章节 | 产出 |
|---|---|---|---|
| A 现状 | AI 逆向工具链长什么样? | §一 ~ §二 | MCP 架构分析 + 行业四阶段模型 |
| B 能力 | AI 能做到什么、做不到什么? | §三 ~ §四 | 成绩单 + 错误分类 + 四维框架 + Agent 缺陷 |
| C 分析 | 工具链如何补强 LLM?趋势如何? | §五 ~ §七 | 四维对位分析 + 实战校准 + 趋势预测 |
| D 改良 | Agent 架构如何升级? | §八 | 三机制改良 + 攻防共演三轮阶梯 |
| E 行动 | 攻防双方该怎么调整? | §九 ~ §十一 | 挑战 llm_challenge.so + 攻击方 6 条 + 防守方 9 条建议 |
先补几个概念
如果你对 OLLVM 混淆不熟,先看这一节,后面的内容会顺畅很多。
| 名词 | 一句话解释 | 打个比方 |
|---|---|---|
| OLLVM | 一个开源的编译期混淆器,在编译时把代码改写得难以阅读 | 把一篇文章打乱重排后再印刷 |
| CFF(控制流平坦化) | 把函数里的 if/else、循环全部拆成小块,放进一个大 switch 里,用一个「状态变量」决定下一块执行谁 | 把一本书拆成活页,每页末尾写「下一页去第 N 页」 |
| BCF(伪造控制流) | 插入永远不会执行的假分支,用一个「看似复杂、实际恒为真/假」的条件挡住 | 在路口立一块永远是绿灯的红绿灯 |
| Opaque Predicate(不透明谓词) | 上面说的「看似复杂、实际结果固定」的条件,例如 x*(x-1) 一定是偶数 | 一道答案永远是「是」的判断题 |
| IS(指令替换) | 把简单运算换成数学上等价但长得完全不同的式子,例如把 a + b 换成 (a ^ b) + 2*(a & b) | 把「1+1」写成「3-1」 |
| MBA(混合布尔-算术表达式) | 把位运算(与、或、异或)和算术运算(加、减、乘)混在一起的表达式,IS 和高级不透明谓词都靠它 | 用多种语言混写一句话 |
| 去混淆 | 把上面这些变形还原成人能看懂的原始逻辑 | 把活页书重新装订 |
Research Evidence
Methodology
| 项目 | 说明 |
|---|---|
| 研究方法 | 文献精读 + 开源项目分析 + 实战经验对照 + 构造挑战样例 |
| 覆盖范围 | 3 篇论文/报告,1 个开源 AI 逆向项目(REA),8 个 LLM,4 种混淆方式,5 类错误 |
| 时间跨度 | 2025-06 ~ 2026-10 |
| 证据分级 | A(一手逆向) / B(可信来源) / C(社区传言) |
Sources & Evidence Grading
| 来源类型 | 数量 | 证据等级 | 说明 |
|---|---|---|---|
| 学术论文(同行评审/预印本) | 2 | A-B | arXiv:2505.19887, arXiv:2604.08083 |
| 安全公司技术博客 | 1 | B | Quarkslab “Defeating AI-Assisted RE” (2026-08) |
| 开源 AI 逆向项目 | 1 | B | morluto/rea — MCP 逆向工程服务器(192K+ Star) |
| 笔者一手逆向/开发经验 | — | A | OLLVM 去混淆、D810G / Ponce4Ghidra / unpack / cap / re-agent 开发实践、SO 逆向分析 |
| 笔者复现验证 | 3 | A | 对论文测试函数的独立验证 |
Scope Limitations
- 论文只测了 x86_64,没测 ARM/AArch64。笔者日常分析的 Android SO 都是 arm64-v8a,部分结论能否迁移还需验证
- 论文使用的 LLM 版本截至 2025 年 3 月,到撰文时(2026-10)模型已经迭代多次
- Quarkslab 的 Agent 实验只用了 Claude Code,没有覆盖其他 Agent 框架
一、引言:从 REA 的 19 万 Star 说起
2026 年上半年,一个名为 REA(Reverse Engineer Anything)的开源项目在 GitHub 上半年拿到了 19 万+ Star。它不是又一个「把代码贴给 LLM」的包装器——它是一个 MCP 服务器,让 AI Agent 通过标准化协议直接驱动 Ghidra、Hopper、IDA。
当笔者第一次看到 REA 的 DX-Ball 案例——Agent 从 x86 游戏二进制中重建函数,通过 3,205 个测试用例,复现全部 63 字节编译输出——第一反应是:作为保护方,我们需要重新评估混淆的有效性了。
几乎同一时间,一位客户在方案评审会上说:
“OLLVM 现在还有意义吗?我把混淆后的代码贴给 GPT,它直接还原出来了。”
这个结论太粗糙了。「贴进去」和「还原出来」之间藏着很多细节:贴的是源码还是汇编?还原到什么程度?运算对不对?常量是不是编的?
但 REA 的存在让这个问题变得更紧迫:当攻击者不再是「人贴汇编给 LLM 猜」,而是 Agent 通过 MCP 指挥真正的反编译器 时,混淆还有多少防御价值?
答案比想象的更微妙:混淆没死,但攻防的经济账正在被彻底改写。 下面先看工具链的最新形态,再用论文数据和攻防实验给出系统评估。
二、AI 逆向工具链的演进:以 REA 为例
REA(Reverse Engineer Anything) 的口号是 “One MCP for reverse engineering across binaries, applications, and runtime behavior.”——一个 MCP 协议,逆向一切。项目作者 morluto 以匿名身份活跃在 GitHub 上,其它公开信息不多,但 REA 本身的代码质量和架构设计(TypeScript 实现、MIT 协议)说明作者对 MCP 生态和逆向工具链有深入理解。2026 年 10 月初 REA 登上 GitHub Trending 后迅速出圈,YouTube 上 Matthew Berman 等科技博主的推介进一步推高了关注度。
2.1 REA 是什么
REA 是一个 MCP(Model Context Protocol)服务器,让 AI Agent 通过标准化协议直接调用专业逆向工具。它不是另一个「把代码贴给 LLM」的包装器,而是让 Agent 拥有了逆向工程师的工具箱。
| 特性 | 说明 |
|---|---|
| MCP 原生 | 通过 MCP 协议暴露工具,Claude Code、Codex、Cursor、Gemini CLI 等 Agent 均可调用 |
| 专业工具集成 | 直接驱动 Ghidra、Hopper、IDA 进行反编译和反汇编,不是用 objdump 凑合 |
| 全栈逆向 | 原生二进制(ELF/Mach-O/PE)、Android APK、.NET、EVM 字节码、固件、JS/Electron、网络抓包 |
| 证据溯源 | 每条发现附带 Evidence 记录,包含来源、覆盖范围、已知局限,可直接传递给对比工具 |
| 字节级验证 | DX-Ball 案例中的函数重建通过了 3,205 个原始 x86 测试用例,复现了全部 63 字节编译输出 |
| 安装即用 | npx rea-agents setup 一条命令注册 MCP 服务器并安装分析工作流 |
这不是「LLM 猜测汇编含义」,而是 Agent 通过 MCP 调用 Ghidra 获取精确的伪代码和调用图,再用 LLM 理解和重建逻辑。三个设计精华值得展开:
精华 1:MCP 标准化——ToolContract + Provider 抽象
所有逆向工具通过统一的 MCP 接口暴露能力。REA 的核心类 EvidenceMcpServer 继承自 MCP SDK 的 McpServer,每个工具通过 ToolContract 注册:
| |
后端差异通过 AnalysisProvider 接口抹平——Ghidra、Hopper、IDA 各自实现同一个 AnalysisClient.execute(operation, parameters) 方法,Agent 侧完全无感:
| |
这与传统的「写 IDA Python 脚本 → 手工解析输出 → 再贴给 LLM」有本质区别。
精华 2:Evidence Ledger——内容寻址的证据账本
论文发现 DeepSeek R1 会凭空编造 0xDEADBEEF 这类常量 [1]。REA 的应对是:每条工具输出都封装为一条 Evidence 记录,用内容的 SHA-256 哈希作为 ID,天然防篡改:
| |
evidence_links 字段让 Evidence 之间形成有向无环图(DAG):反编译结果引用二进制加载记录,交叉引用结果引用反编译记录。LLM 的任何推理结论都可以沿着链条追溯到原始工具输出——常量是 Ghidra 在地址 0x4012a0 反编译出来的,还是 LLM 自己编的,一查便知。
精华 3:原子化工具 + 组合工作流——按需查询
传统做法是把整个反汇编塞进上下文窗口。REA 把能力拆成两层:底层原子工具和上层组合工作流。
底层原子工具(official-proxy,直接映射到 Ghidra/IDA 操作):
├── 导航:list_procedures, list_segments, list_strings, list_names
├── 检查:procedure_pseudo_code, procedure_assembly, procedure_info
├── 引用:xrefs, procedure_callers, procedure_callees
├── 搜索:search_procedures, search_strings (literal / regex)
└── 标注:set_comment, set_bookmark, annotate_native_function

上层组合工具(enhanced,串联多个原子操作 + 逐步返回 Evidence):
├── trace_feature    → strings → procedures → xrefs(特征追踪)
├── get_call_graph   → 从符号出发遍历 callers/callees(调用图)
├── trace_call_path  → 找 start 到 goal 之间的调用路径
├── batch_decompile  → 并发反编译多个函数
└── binary_overview  → 元数据 + 统计(分析入口点)
Agent 的典型操作链——以分析 libsign.so 的签名校验为例:
Agent                            REA (MCP Server)               Ghidra
  │                                  │                              │
  ├─ binary_overview("libsign.so") ──►│─── 加载 + 分析 ──────────────►│
  │◄── Evidence: 42 functions,       │◄── segments, exports ────────│
  │    3 segments, arch=arm64        │                              │
  │                                  │                              │
  ├─ list_procedures() ─────────────►│                              │
  │◄── Evidence: [verify_sig,        │                              │
  │    init_ctx, get_dev_id, ...]    │                              │
  │                                  │                              │
  │  "verify_sig 像是入口"            │                              │
  ├─ procedure_pseudo_code ─────────►│─── 反编译 ──────────────────►│
  │   ("verify_sig")                 │◄── 伪代码 ─────────────────│
  │◄── Evidence: if (hmac(...)==..)  │                              │
  │    confidence: "observed"        │                              │
  │    provider: ghidra 11.3         │                              │
  │                                  │                              │
  │  "hmac 的 key 从哪来?"           │                              │
  ├─ xrefs("key", direction: ───────►│─── 交叉引用查询 ────────────►│
  │        "incoming")               │◄── 引用列表 ────────────────│
  │◄── Evidence: key ← get_dev_id() │                              │
  │    evidence_links: [ev_abc...]   │  ← 引用了上一条 Evidence      │
  │                                  │                              │
  ├─ procedure_pseudo_code ─────────►│                              │
  │   ("get_dev_id")                 │                              │
  │◄── Evidence: reads /proc/cpuinfo │                              │
  │                                  │                              │
  │  【结论】key = SHA256(cpuinfo)    │                              │
  │  全链条 Evidence 可追溯 ✓         │                              │
每一步只请求需要的信息,既节省上下文空间,也让 LLM 能专注于当前问题。annotations 中的 readOnlyHint、idempotentHint 等元数据进一步帮助 Agent 规划调用顺序——只读工具可以随意重试,有副作用的工具需要谨慎调用。
⚠️ 国内用户特别提醒
不建议国内用户使用 REA 驱动 Claude 进行逆向工程分析。 REA 的 MCP 工作模式会在短时间内产生密集的工具调用请求(反编译、符号解析、调用图提取、内存读取等),这种高频自动化调用模式容易触发 Anthropic 的风控系统,导致账号被限制乃至永久封禁(Anthropic 使用政策明确禁止自动化滥用,社区已有多起因 MCP 密集调用被封号的报告)。国内用户获取和恢复 Claude 账号的成本显著高于海外用户,一旦触发风控,损失往往不可逆。
替代方案:
- 优先使用本地部署的开源模型(DeepSeek、Qwen 等)作为 MCP Host,REA 本身支持多种 LLM 后端
- 使用 Ghidra 脚本 + 本地 LLM(通过 Ollama 部署)的组合,完全离线运行
- 如确需使用云端模型,严格控制调用频率,单次分析会话不超过 30 分钟,并仔细阅读服务条款
2.2 DX-Ball 案例:字节级精确重建
REA 的 DX-Ball 案例展示了当前 AI 逆向的实际上限。Agent 从一个 x86 游戏二进制中重建了声像计算函数,结果:
- 通过 3,205 个原始 x86 测试用例 [7]
- 复现了全部 63 字节的编译输出 [7]
这不是「LLM 猜了个差不多的实现」——这是字节级精确的函数重建。它说明:对于「可以被 Ghidra 完整反编译、逻辑相对独立」的函数,AI Agent + 专业工具已经能做到人类分析师级别的准确度。
但也要注意局限:DX-Ball 的目标函数逻辑清晰、没有混淆。面对组合混淆的函数,即使有 Ghidra 的反编译输出,LLM 仍然会在多个维度上失败——具体哪些维度,后面的四维框架会详细分析。
笔者点评:DX-Ball 的真实含金量
DX-Ball 是未混淆的 x86 游戏二进制,被重建的声像计算函数逻辑清晰、自包含、无副作用——这是 AI 逆向的「理想靶标」。人类分析师处理同样的函数,反编译后大约需要半天完成同等质量的重建(含测试),主要时间花在理解调用约定和逐一验证边界条件上。AI 在这里的优势不是「更聪明」,而是「更快且不嫌烦」——3,205 个测试用例的逐字节比对,人工做是不现实的。
但真实世界的逆向目标几乎不会这么干净。笔者日常接触的 Android SO,一个签名校验函数就可能涉及 JNI 回调、全局状态、线程同步和多层混淆叠加。DX-Ball 证明的是 AI 精确重建的能力上限,不是它在生产环境中的常规表现。 把「能把简单函数重建到字节级一致」和「能逆向真实世界的混淆二进制」画等号,是当前 AI 逆向讨论中最常见的认知偏差。
2.3 REA 揭示的行业趋势
REA 19 万+ Star 的速度说明社区对 AI 逆向工具链的需求是真实的 [7]。结合 ReArk(HarmonyOS/Android AI 逆向,600+ Star)[8] 等项目,行业正在经历一次范式转移:
从「LLM 理解汇编」到「Agent 驱动专业工具链」。
| 阶段 | 代表形态 | 对保护方的威胁 |
|---|---|---|
| 1.0 聊天辅助 | 把汇编贴给 ChatGPT | 低:需要人工判断 |
| 2.0 脚本集成 | LLM + IDA/Ghidra 脚本 | 中:半自动化 |
| 3.0 MCP 工具链 | REA:Agent 通过 MCP 驱动 Ghidra/Hopper/IDA | 高:专业工具 + LLM 理解力 |
| 4.0 端到端自主 | Agent 集群 + 动态追踪 + 自动验证 | 极高:全自动 + 并行 + 通宵 |
REA 已经处在 3.0:它不是用 LLM 模拟逆向工程师,而是让 LLM 指挥真正的逆向工具,拿到确定性的分析结果后再做判断。
那么,AI + 工具链的组合到底能拆多少混淆? 要回答这个问题,需要一个系统的能力评估框架。
三、论文核心发现:四维框架
3.1 为什么这篇论文值得读
大多数「LLM + 逆向」的讨论停留在演示层面:贴一段代码,截一张图,宣布混淆已死。Promon 团队的论文(arXiv:2505.19887)做得更严谨。Promon 是一家挪威移动安全公司,2006 年成立于奥斯陆,技术源自 SINTEF 和奥斯陆大学的研究,核心产品 Promon SHIELD 是一套运行时应用自保护(RASP)方案,服务于银行、游戏、医疗等行业。论文的三位作者 Anton Tkachenko、Dmitrij Suskevic 和 Benjamin Adolphi 均来自 Promon,他们对混淆技术有丰富的一线经验——毕竟 Promon 自身就是混淆方案的提供商,这让论文在评估框架的设计上兼顾了攻防双方的视角。具体来说,他们:
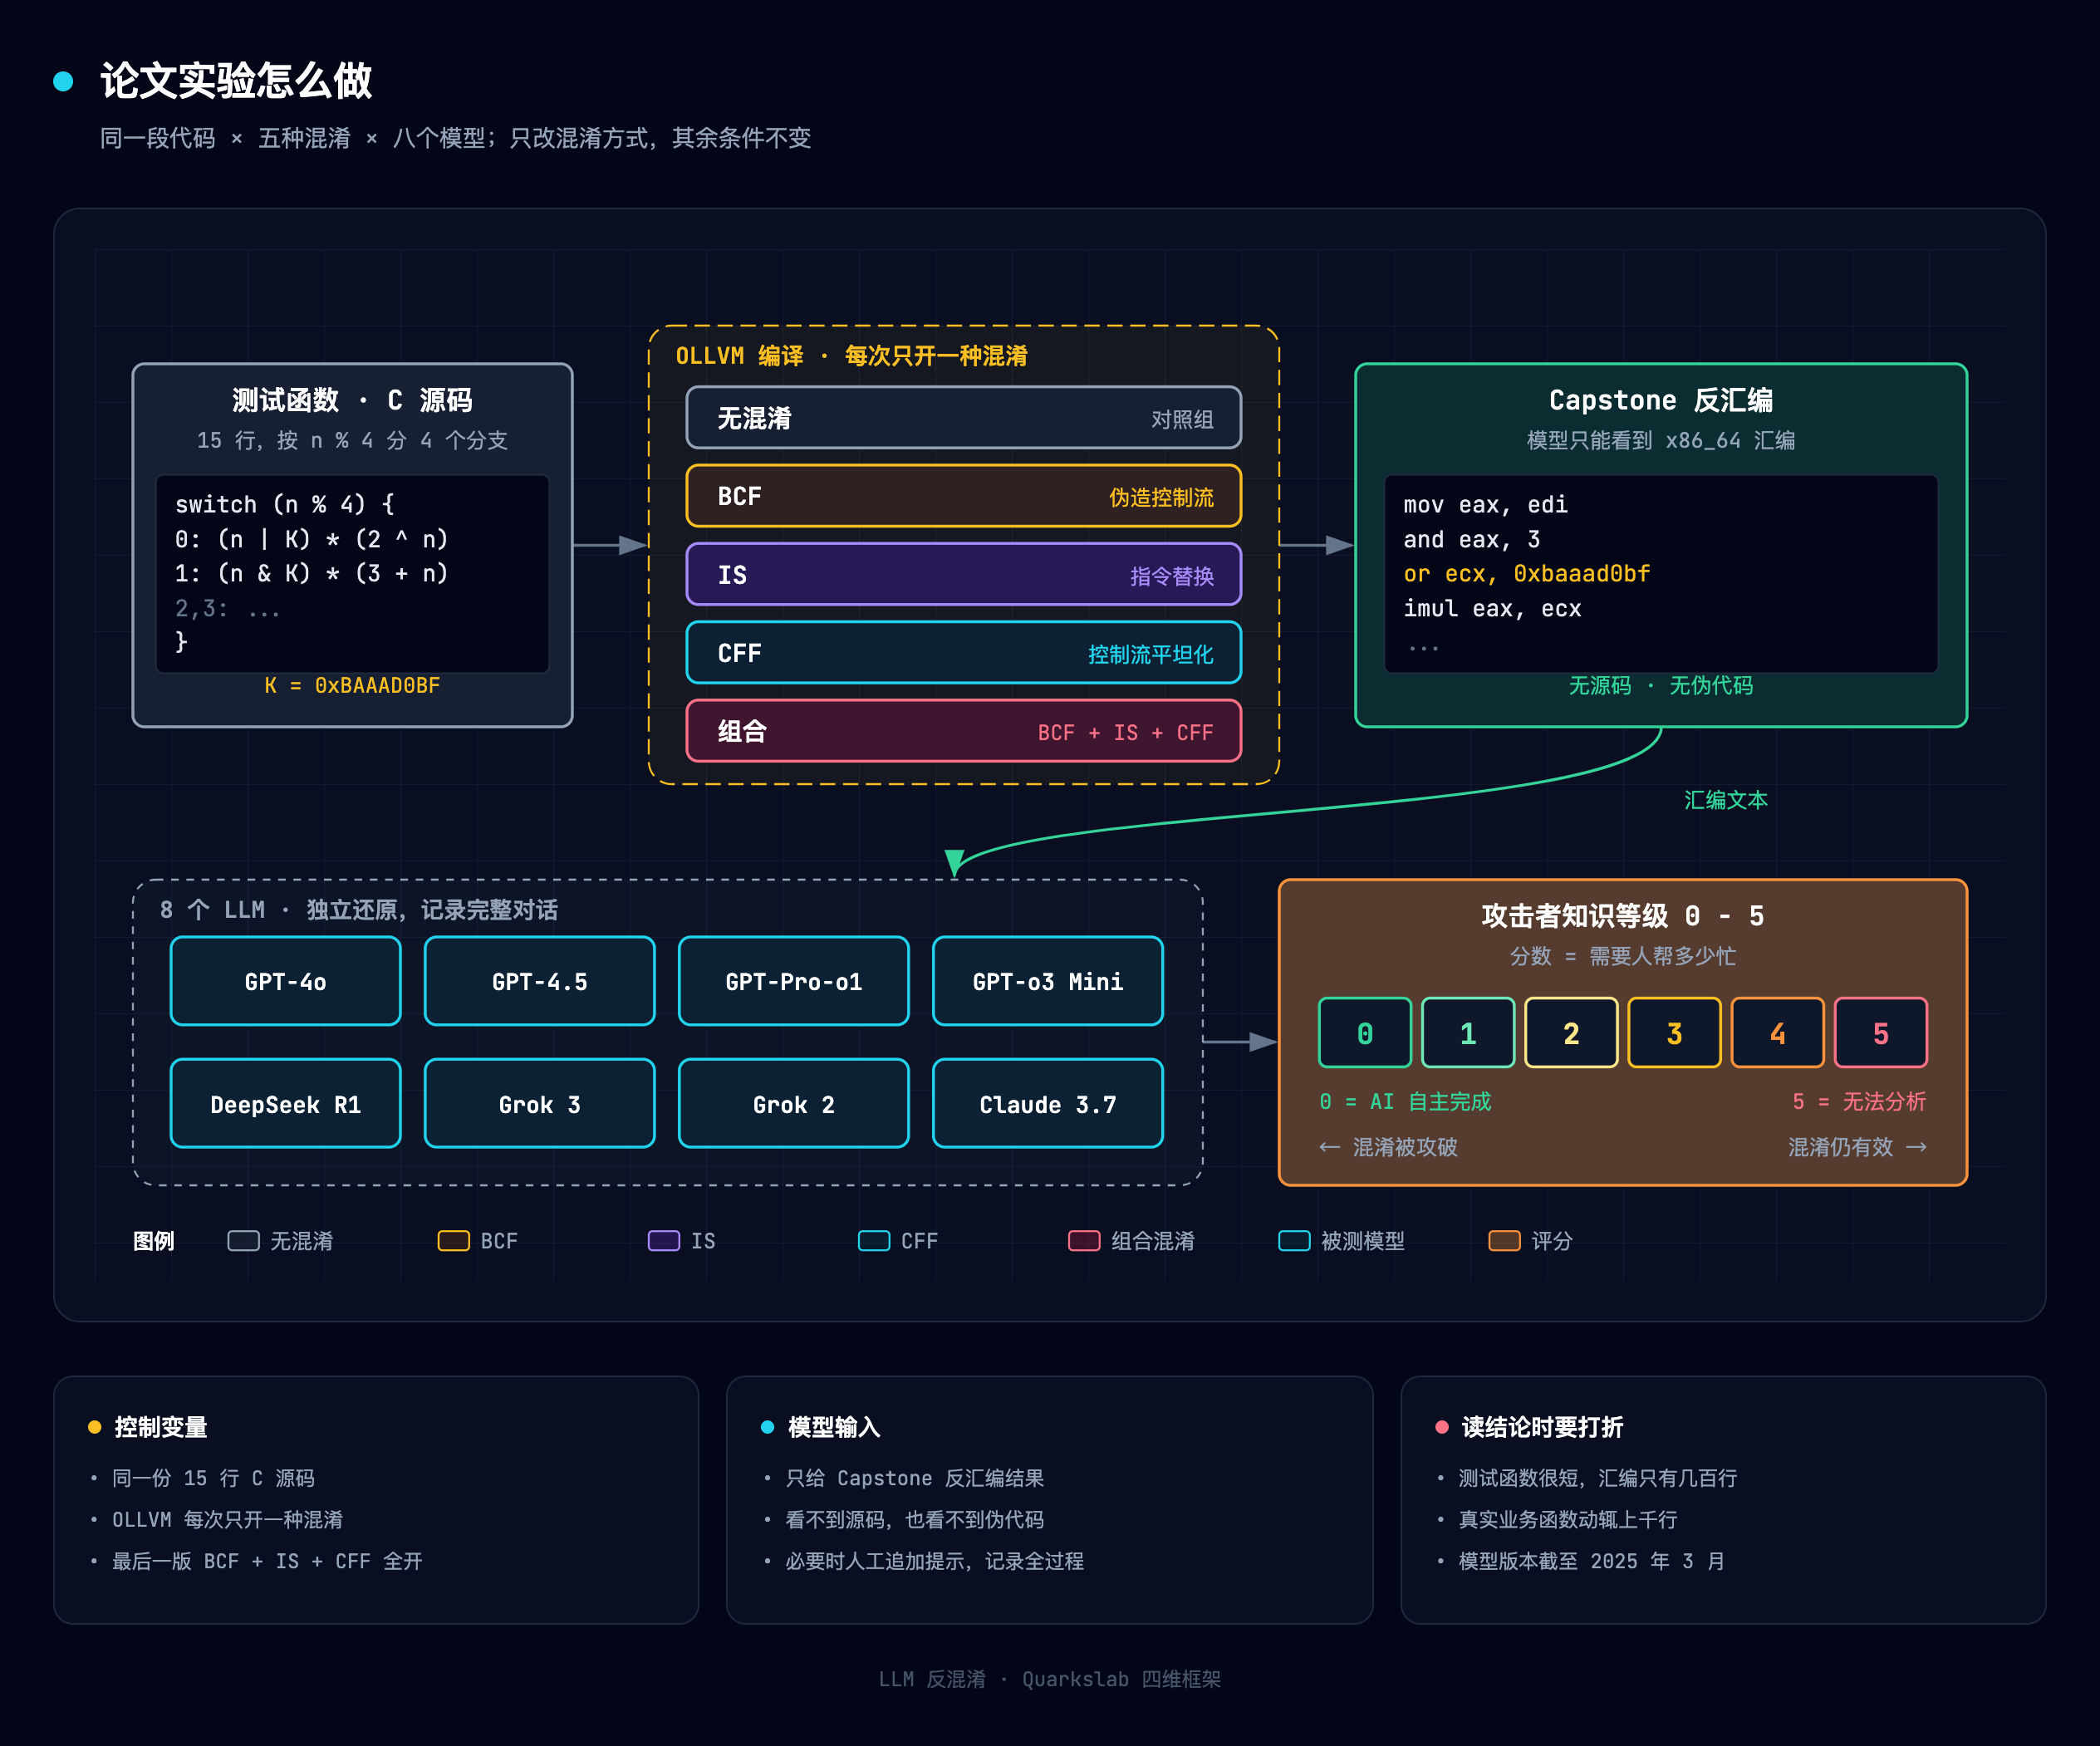
- 同一段 C 代码,用 OLLVM 编译出 5 个版本(无混淆 / BCF / IS / CFF / 全部组合)
- 让 8 个主流 LLM 分别去还原 x86_64 汇编(不是源码,也不是伪代码)
- 记录完整对话,统一打分,最后总结出一个四维分析框架
论文里有三个发现最出乎笔者意料:
- 只有 Claude 3.7 Sonnet 能自己认出不透明谓词 [1],不需要任何提示
- 面对组合混淆,所有模型全部失败 [1]。混淆没死,只是要换策略
- DeepSeek R1 会凭空编造常量 [1],比如
0xDEADBEEF、0xCAFEBABE。这些「程序员调试用的占位数」在原代码里根本不存在,是模型从训练数据里「借」来的
只想看结论,可以直接跳到 §3.6「三层抵抗力模型」。
3.2 测试设计
被测函数很短:按 n % 4 分成四个分支,每个分支做一次不同的运算,用到一个标志性常量 0xBAAAD0BF:
| |
函数简单是有意为之:还原得对不对,一眼就能看出来。连这个都还原不了,面对真实世界几千行的签名函数就更不用说了。
五个混淆版本:
| 版本 | OLLVM 编译选项 | 含义 |
|---|---|---|
code_unobf | 无 | 对照组 |
code_bcf | -mllvm -bcf -mllvm -boguscf-prob=100 -mllvm -boguscf-loop=1 | 伪造控制流 |
code_sub | -mllvm -sub | 指令替换 |
code_fla | -mllvm -fla -mllvm -perFLA=100 | 控制流平坦化 |
code_all | 以上全部 | 三重混淆 |
整个实验流程如下:
3.3 成绩单:谁活下来了?
表中数字是「攻击者知识等级」,越低越好:0 表示 AI 独立完成,5 表示需要专家几乎重写,- 表示完全无法分析。
| 模型 | BCF | IS | CFF | 组合 |
|---|---|---|---|---|
| GPT-4o | 4 | 4 | 1 | - |
| GPT-4.5 | 1-2 | 4 | 0 | 5 |
| GPT-Pro-o1 | 3 | - | 0 | 5 |
| GPT-3o Mini | 4-5 | - | - | - |
| DeepSeek R1 | 5 | 5 | 1-2 | 5 |
| Grok 3 | 1 | 4 | 0 | 5 |
| Grok 2 | - | - | 1-2 | - |
| Claude 3.7 Sonnet | 0 | 1-2 | 0-1 | 5 |
⚠️ 模型版本时效性提醒
论文(arXiv:2505.19887)的实验在 2025 年 3 月前完成,距本文撰写时(2026-10)已过去约 19 个月。这段时间内主流模型经历了多次大版本迭代,上表中的成绩只反映当时版本的能力,不代表当前最新模型的表现。以下是论文使用版本与截至 2026-10 最新版本的对照:
论文使用的模型 推测参数量级 论文测试时版本 截至 2026-10 最新版本 代际差距 GPT-4o ~200B MoE 2024-05 发布 GPT-6 Sol(2026-10) 4+ 代 GPT-4.5 ~200B+ MoE 2025-02 预览 GPT-6 Sol(2026-10) 3+ 代 GPT-Pro-o1 ~300B MoE(推理链) 2024-12 发布 GPT-6 Astra(2026-09),o 系列退役中 3+ 代 GPT-3o Mini ~8B 蒸馏 2024-07 发布 GPT-6 Luna(2026-10) 4+ 代 DeepSeek R1 671B MoE(37B 激活) 2025-01 发布 R2 仍未发布;通用线升级至 V4.1-Flash(2026-09) 1 代(通用线) Grok 3 未公开(推测 ~300B MoE) 2025-02 发布 Grok 4.7(2026-09) 3 代 Grok 2 未公开(推测 ~100B MoE) 2024-08 发布 Grok 4.7(2026-09) 4 代 Claude 3.7 Sonnet 未公开 2025-02 发布 Fable 5.1 / Sonnet 5.5(2026-09) 3+ 代 这意味着什么?
- 论文中 CFF「全军覆没」的结论大概率仍然成立——CFF 在当时就已经被多数模型攻破,更新的模型只会更强
- IS 的 4-5 级是否还成立是最大的悬念:GPT-6 Astra、Claude 5.5 系列在数学推理上有显著提升,IS 的防线可能已经松动
- 组合混淆的 5 级大概率仍然成立——它考验的是四个维度的交互复杂性,不是单一维度的推理能力
- DeepSeek R2 始终未发布(R1 仍为最新推理模型),OpenAI 的 o 系列推理模型已被 GPT-6 系列替代(o4-mini 于 2026-10-23 下线)
- 本文的趋势判断已经考虑了模型迭代因素(见 §七),读者引用论文数据时应注明模型版本
这张表可以按三个方向读:
竖着看(按混淆类型):CFF 反而最容易被攻破,GPT-4.5、GPT-Pro-o1、Grok 3 都拿到了 0 级。笔者之前用 angr 符号执行做 CFF 还原,跑了 23 分钟才处理完 47 个状态 [5];LLM 不需要任何符号执行引擎,直接看汇编就还原了 [1]。
横着看(按模型):Claude 3.7 Sonnet 在 BCF 上是 0 级,是唯一一个自己认出 (x * (x - 1)) & 1 == 0 恒为真的模型 [1]。但到了 IS,它没去还原原始常量,而是试图总结一个更「优雅」的数学规律。思路漂亮,但结果是错的。
看最后一列(组合混淆):全军覆没。这是整篇论文最重要的结论 [1]:单一混淆正在被 LLM 侵蚀,但多种混淆叠加仍然非常有效。
3.4 四维框架
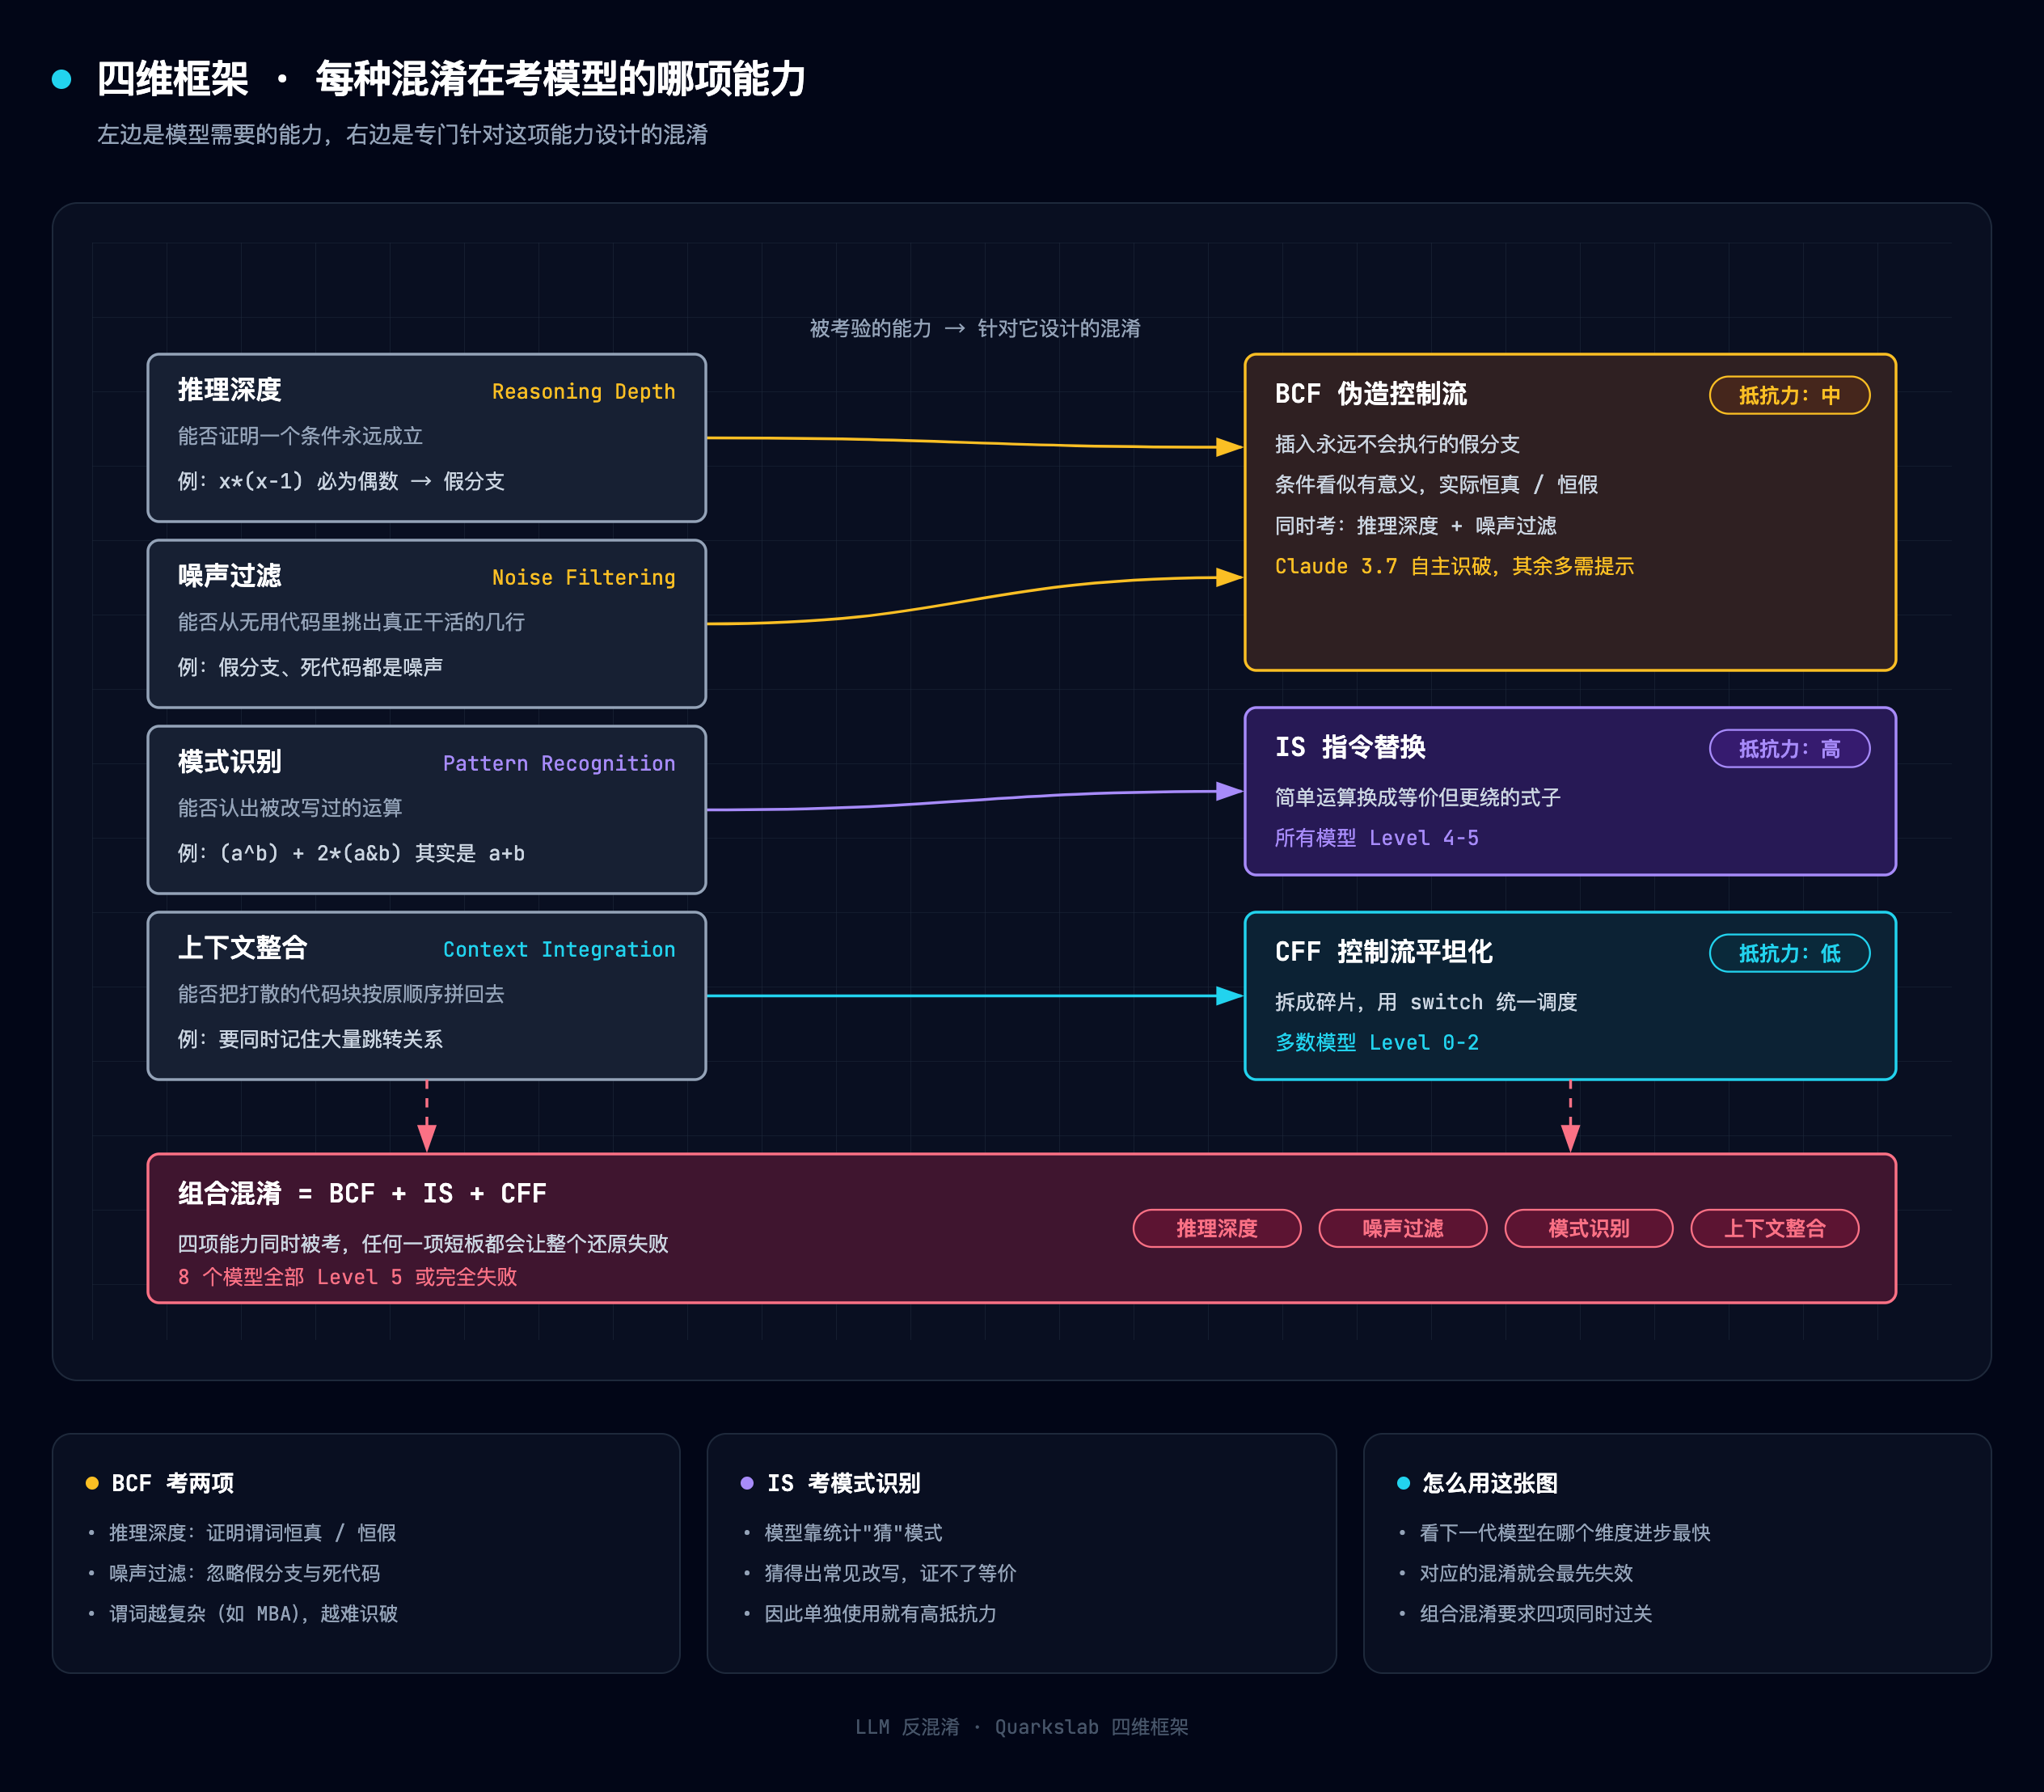
论文用四个「能力维度」来解释上面的差异。这个框架更大的价值在于预测:下一代模型出来时,保护方应该优先加固哪里。
| 维度 | 通俗解释 | 被哪种混淆考验 | 表现最好的模型 |
|---|---|---|---|
| 推理深度 Reasoning Depth | 能不能「证明」一个条件永远成立 | BCF | Claude 3.7、GPT-4.5、Grok 3 |
| 模式识别 Pattern Recognition | 能不能认出「换了个写法的同一个运算」 | IS | 全部较差(4-5 级) |
| 噪声过滤 Noise Filtering | 能不能从一堆假代码里挑出真逻辑 | BCF | Claude 3.7、GPT-Pro-o1 |
| 上下文整合 Context Integration | 能不能把拆散的碎片重新拼成完整流程 | CFF | GPT-4.5、GPT-Pro-o1、Grok 3 |
为什么 LLM 在「模式识别」上最弱?因为 IS 生成的等价式在训练数据里很少见,而 LLM 靠的是统计规律,不是数学证明。D810G 的 MBA 化简引擎做的就是这件事:用 6 组共 96 条规则——基础规则、Hacker’s Delight 规则、OLLVM 专有规则、常量折叠规则、高级规则和规则链——把 (x & y) + (x | y) 认成 x + y,每条规则都经过 Z3 在 32 位和 64 位下的等价性证明(源码与规则库)[6]。整个化简通过 7-pass 流水线执行(MBA 化简 → CFF 还原 → 不透明谓词消除 → BCF 清理 → 死代码移除 → 字符串解密 → fixpoint 收敛),前一步的输出喂给下一步,直到没有新的化简发生。笔者在开发中的体会是,规则库覆盖面决定了化简效果的上限,而这恰好是 LLM 最不擅长的维度。
核心洞察:统计相关 ≠ 数学等价
四维框架揭示了一个更本质的问题:LLM 的「理解」建立在统计相关性之上——它见过足够多的
if/else被拆成switch的案例,所以能还原 CFF;但它从未在训练数据中见过(a ^ b) + 2*(a & b)等于a + b的证明过程,而只可能见过少量成对出现的例子。CFF 还原本质上是模式匹配问题,IS 还原是数学证明问题——这是两种根本不同的认知任务。这也解释了为什么 Claude 3.7 在 BCF 上一枝独秀:不透明谓词
x*(x-1)的判定恰好处于「模式匹配」和「数学推理」的交界处——有足够多的数论直觉可以利用,但又需要一步逻辑推导才能确认恒为真。Claude 的 extended thinking 能力让它跨过了这条线,而其他模型停在了线的这一边。对保护方的启示:混淆的目标应该从「增加代码量」转向「制造数学证明负担」——IS 和 MBA 之所以有效,正是因为它们把逆向问题从模式识别推向了定理证明。
3.5 LLM 最常犯的 5 类错误
3.5.1 谓词误判
不透明谓词 (x * (x - 1)) & 1 == 0 利用了「相邻两个整数相乘一定是偶数」。GPT-4o 没看出来,把它当成真正的条件分支,导致整个控制流还原错误。
论文中 8 个模型只有 3 个能认出这个最基础的模板 [1]。如果换成更复杂的 MBA 变种,比如 (x | (x-1)) - (x ^ (x-1)) >= 0,笔者推测命中率会更低。
注意这个变种只在无符号运算下恒成立:左边其实等于 x & (x-1),按有符号数解释时可能是负数(例如 x = 0xC0000000)。分析时如果搞错了符号语义,人和 LLM 都会误判。
3.5.2 结构映射错误
运算找对了,但对应关系接错了。Grok 2 在 CFF 场景中正确提取出 4 个算术表达式,却把其中 3 个分配给了错误的分支条件。
这也是手工做 CFF 还原时最常见的坑:状态变量的值是对的,但「从哪个状态跳到哪个状态」接错了。D810G 用 Unicorn 模拟执行来确定每个状态的真实后继——从入口状态开始逐个模拟,记录每个 case 执行完后状态变量被赋成了什么值,再用这条实际执行路径重建原始控制流。它同时支持 OLLVM 和 Tigress 两种 CFF 变种,覆盖 x86_64 和 ARM64(AArch64)两种架构 [6]。LLM 在结构映射上的失败,恰好说明 CFF 还原不能只靠模式匹配——需要真正「跑一遍」才能确定状态转移关系。
3.5.3 把混淆误判成循环
DeepSeek R1 和 GPT-3o Mini 把 BCF 中反复出现的条件检查误认为循环 [1]。DeepSeek R1 甚至凭空写出了一个 for _ in range(10),而原函数里没有任何循环:
| |
这个误判情有可原:CFF 的分发结构本身就长得像循环(while(true) { switch(state) {...} }),但每个 case 实际只执行一次。要区分真循环和 CFF 分发器,需要观察状态变量的赋值方式,LLM 缺少这种先验知识。
3.5.4 算术还原错误
所有尝试 IS 的模型都在算术上出了错 [1]。原代码分支 0 是 (n | 0xBAAAD0BF) * (2 ^ n),GPT-4o 给出的是 (input ^ 0xe6c98769) * ((input & 2) | 2),其中 0xe6c98769 在原汇编里根本不存在。
IS 的常见替换规则如下,人类分析师也需要查表或借助求解器才能确认:
| 原运算 | 替换后 |
|---|---|
a + b | (a ^ b) + 2*(a & b) |
a - b | (a ^ b) - 2*(~a & b) |
a | b | (a & b) + (a ^ b) |
3.5.5 常量捏造
这是论文里最离谱的发现。DeepSeek R1 在组合混淆场景下的输出:
| |
0xBAADF00D、0xDEADBEEF 是程序员调试时常用的占位数(俗称 hexspeak),在原代码中完全不存在。模型解析不出真实常量时,就退回到训练数据里最常见的值。被指出错误后,DeepSeek R1 承认了,但没能给出有效修正。
实用建议:LLM 给出的任何常量,都应该回到二进制里搜一遍确认存在;给出的任何表达式,都应该用 Z3 之类的求解器验证与原代码等价。
D810G 为此提供了 verify 命令 [6]:输入原始表达式和 LLM 的还原结果,它会在 32 位和 64 位下用 Z3 证明两者等价,或者给出一个反例输入,同时标出来源不明的常量和 hexspeak 常量。D810G 不依赖 Ghidra GUI 运行——它提供独立的命令行模式(python -m d810g_engine cli),支持 headless 批量分析,可以直接集成到 CI/CD 流水线或脚本中。整个项目通过 398 个测试用例覆盖各种混淆场景,确保每条化简规则的正确性 [6]:
| |
也就是说,LLM 负责快速给出候选答案,确定性工具负责验证,两者正好互补。
3.6 三层抵抗力模型
综合以上数据,论文把混淆方式按抵抗力分成三层:
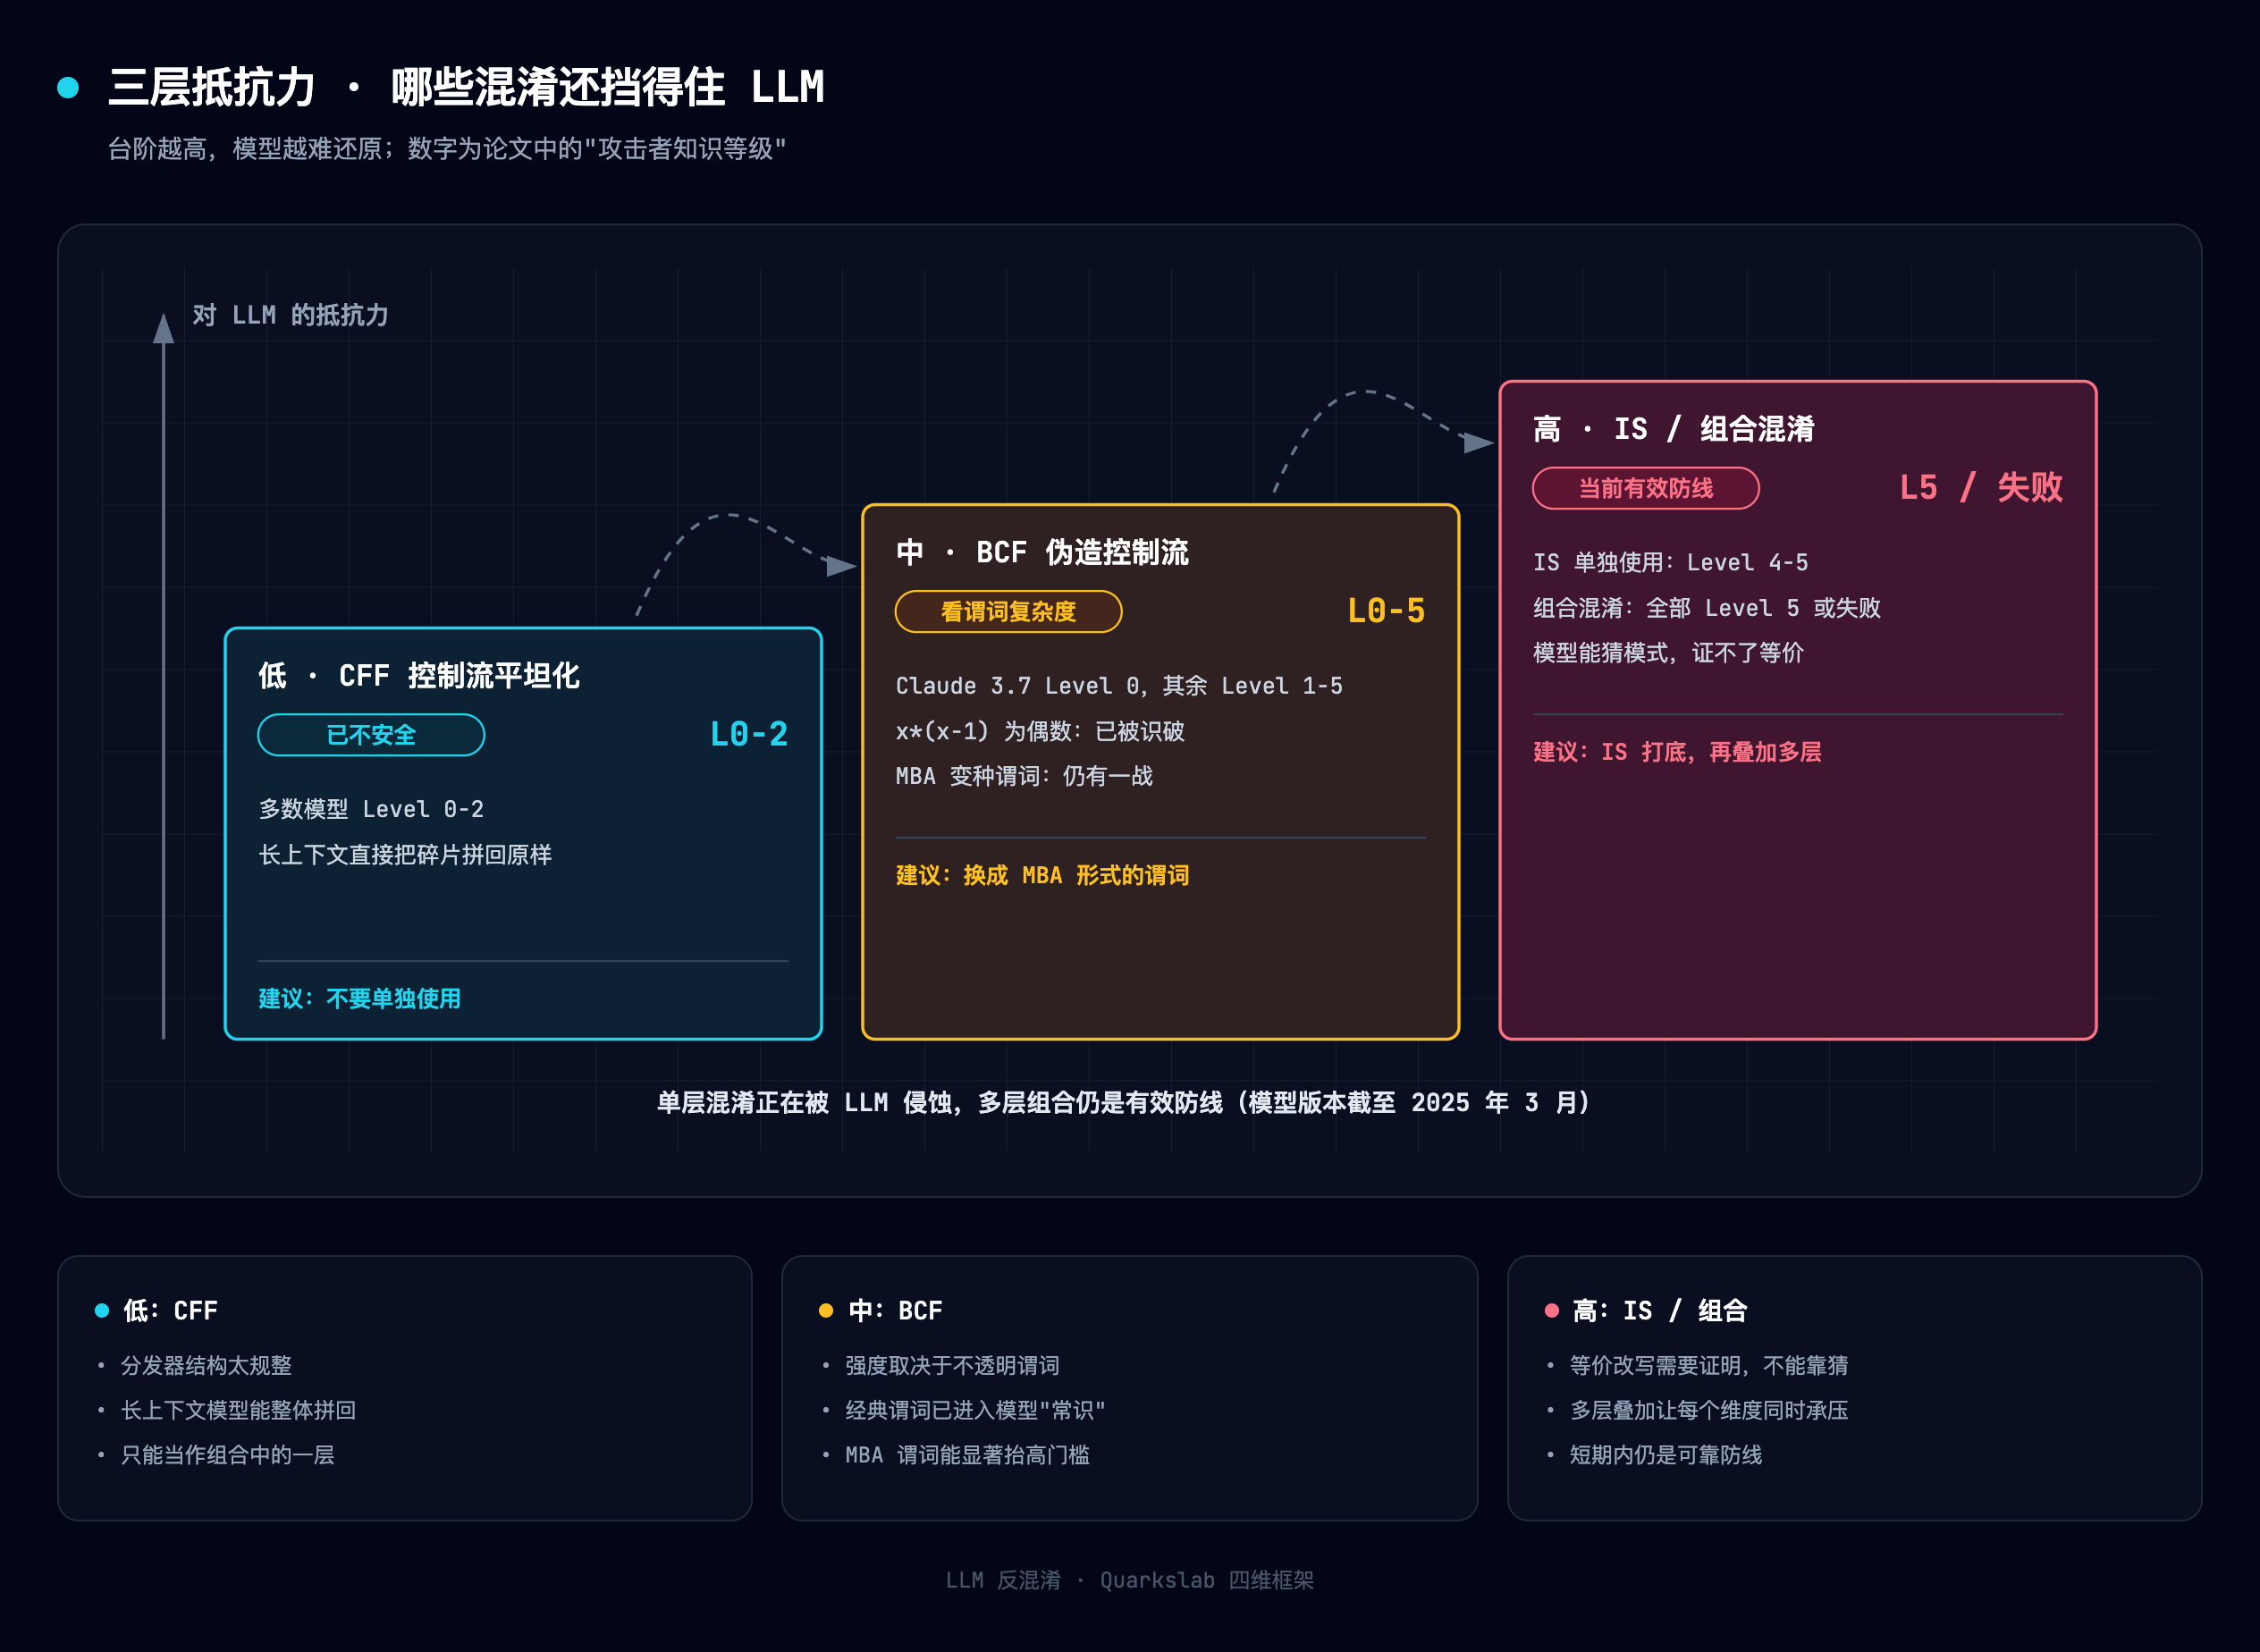
| 抵抗力 | 混淆方式 | 主要考验的维度 | LLM 表现 | 笔者解读 |
|---|---|---|---|---|
| 低 | CFF | 上下文整合 | 多数模型 0-2 级 | 单独使用已不安全,LLM 的长上下文能力直接把碎片拼回去了 |
| 中 | BCF | 推理深度 | Claude 0 级,其余 1-5 级 | 取决于谓词复杂度:简单的 x*(x-1) 已被攻破,MBA 变种还能撑一阵 |
| 高 | IS 与组合混淆 | 模式识别 + 全部维度 | 全部 5 级或失败 | 当前最有效的防线,但要持续关注模型进步 |
笔者点评:四维框架的实战共鸣
样本复杂度:论文用的测试函数只有十几行 C 代码、4 个 if-else 分支,算是 OLLVM 混淆的最小可演示单元。人类分析师面对这种复杂度,无混淆版本 5 分钟看懂,CFF 版本 30 分钟到 1 小时(主要在理清状态机),IS 版本取决于你对 MBA 的经验——第一次遇到可能花半天,有规则库则可以快速查表。组合版本即使有经验也要几个小时。用这么小的样本就能把 8 个模型全部打到 5 级,说明混淆的维度交叉效应非常强。
哪些发现在意料之内,哪些在意料之外? CFF 被攻破和常量捏造,圈子里已有体感,缺的是严谨数据。真正让笔者意外的是 IS 对 LLM 的碾压——笔者在开发 D810G 时花了大量时间写 MBA 规则,但从没想过 LLM 面对 IS 会这么无力(4-5 级几乎等于完全失败)。这印证了一个直觉:天天和一类问题打交道时,会低估它对别人(包括 AI)的难度。
需要注意:论文测试的是 x86_64 汇编,不是 Ghidra 反编译后的伪代码,LLM 在伪代码上的表现很可能好一档。另外测试样本只有一个函数——真实场景中多函数交叉引用会让问题更难,但同时也给 LLM 提供了更多语义线索。框架的价值在于评估维度,不在于具体分数——分数会随模型迭代变化,但「哪个维度最脆弱」的排序短期内不会翻转。
有了这个能力评估框架,接下来看看当 AI 从「被动回答问题」变成「主动动手攻击」时,会暴露哪些新问题。
四、Quarkslab 的攻防实验
Quarkslab 是一家法国网络安全公司,2011 年由 Fred Raynal(MISC 杂志创始人、SSTIC 联合创始人)在巴黎创立,目前约 100 名员工(巴黎和雷恩),2026 年被 Airbus 收购。Quarkslab 在混淆领域有深厚积累:早在 2014 年,Francis Gabriel 就发表过基于 Miasm 框架的 OLLVM 去混淆研究(至今仍是该领域引用最多的技术博客之一)[4];其商业产品 Epona 是一套基于 LLVM 的混淆编译器。这篇博客的作者 Remy Salim 于 2026 年 8 月发表了「Defeating AI-Assisted Reverse Engineering」[2],把实验从「人贴汇编给 LLM」推进到了「Agent 自主攻击」。
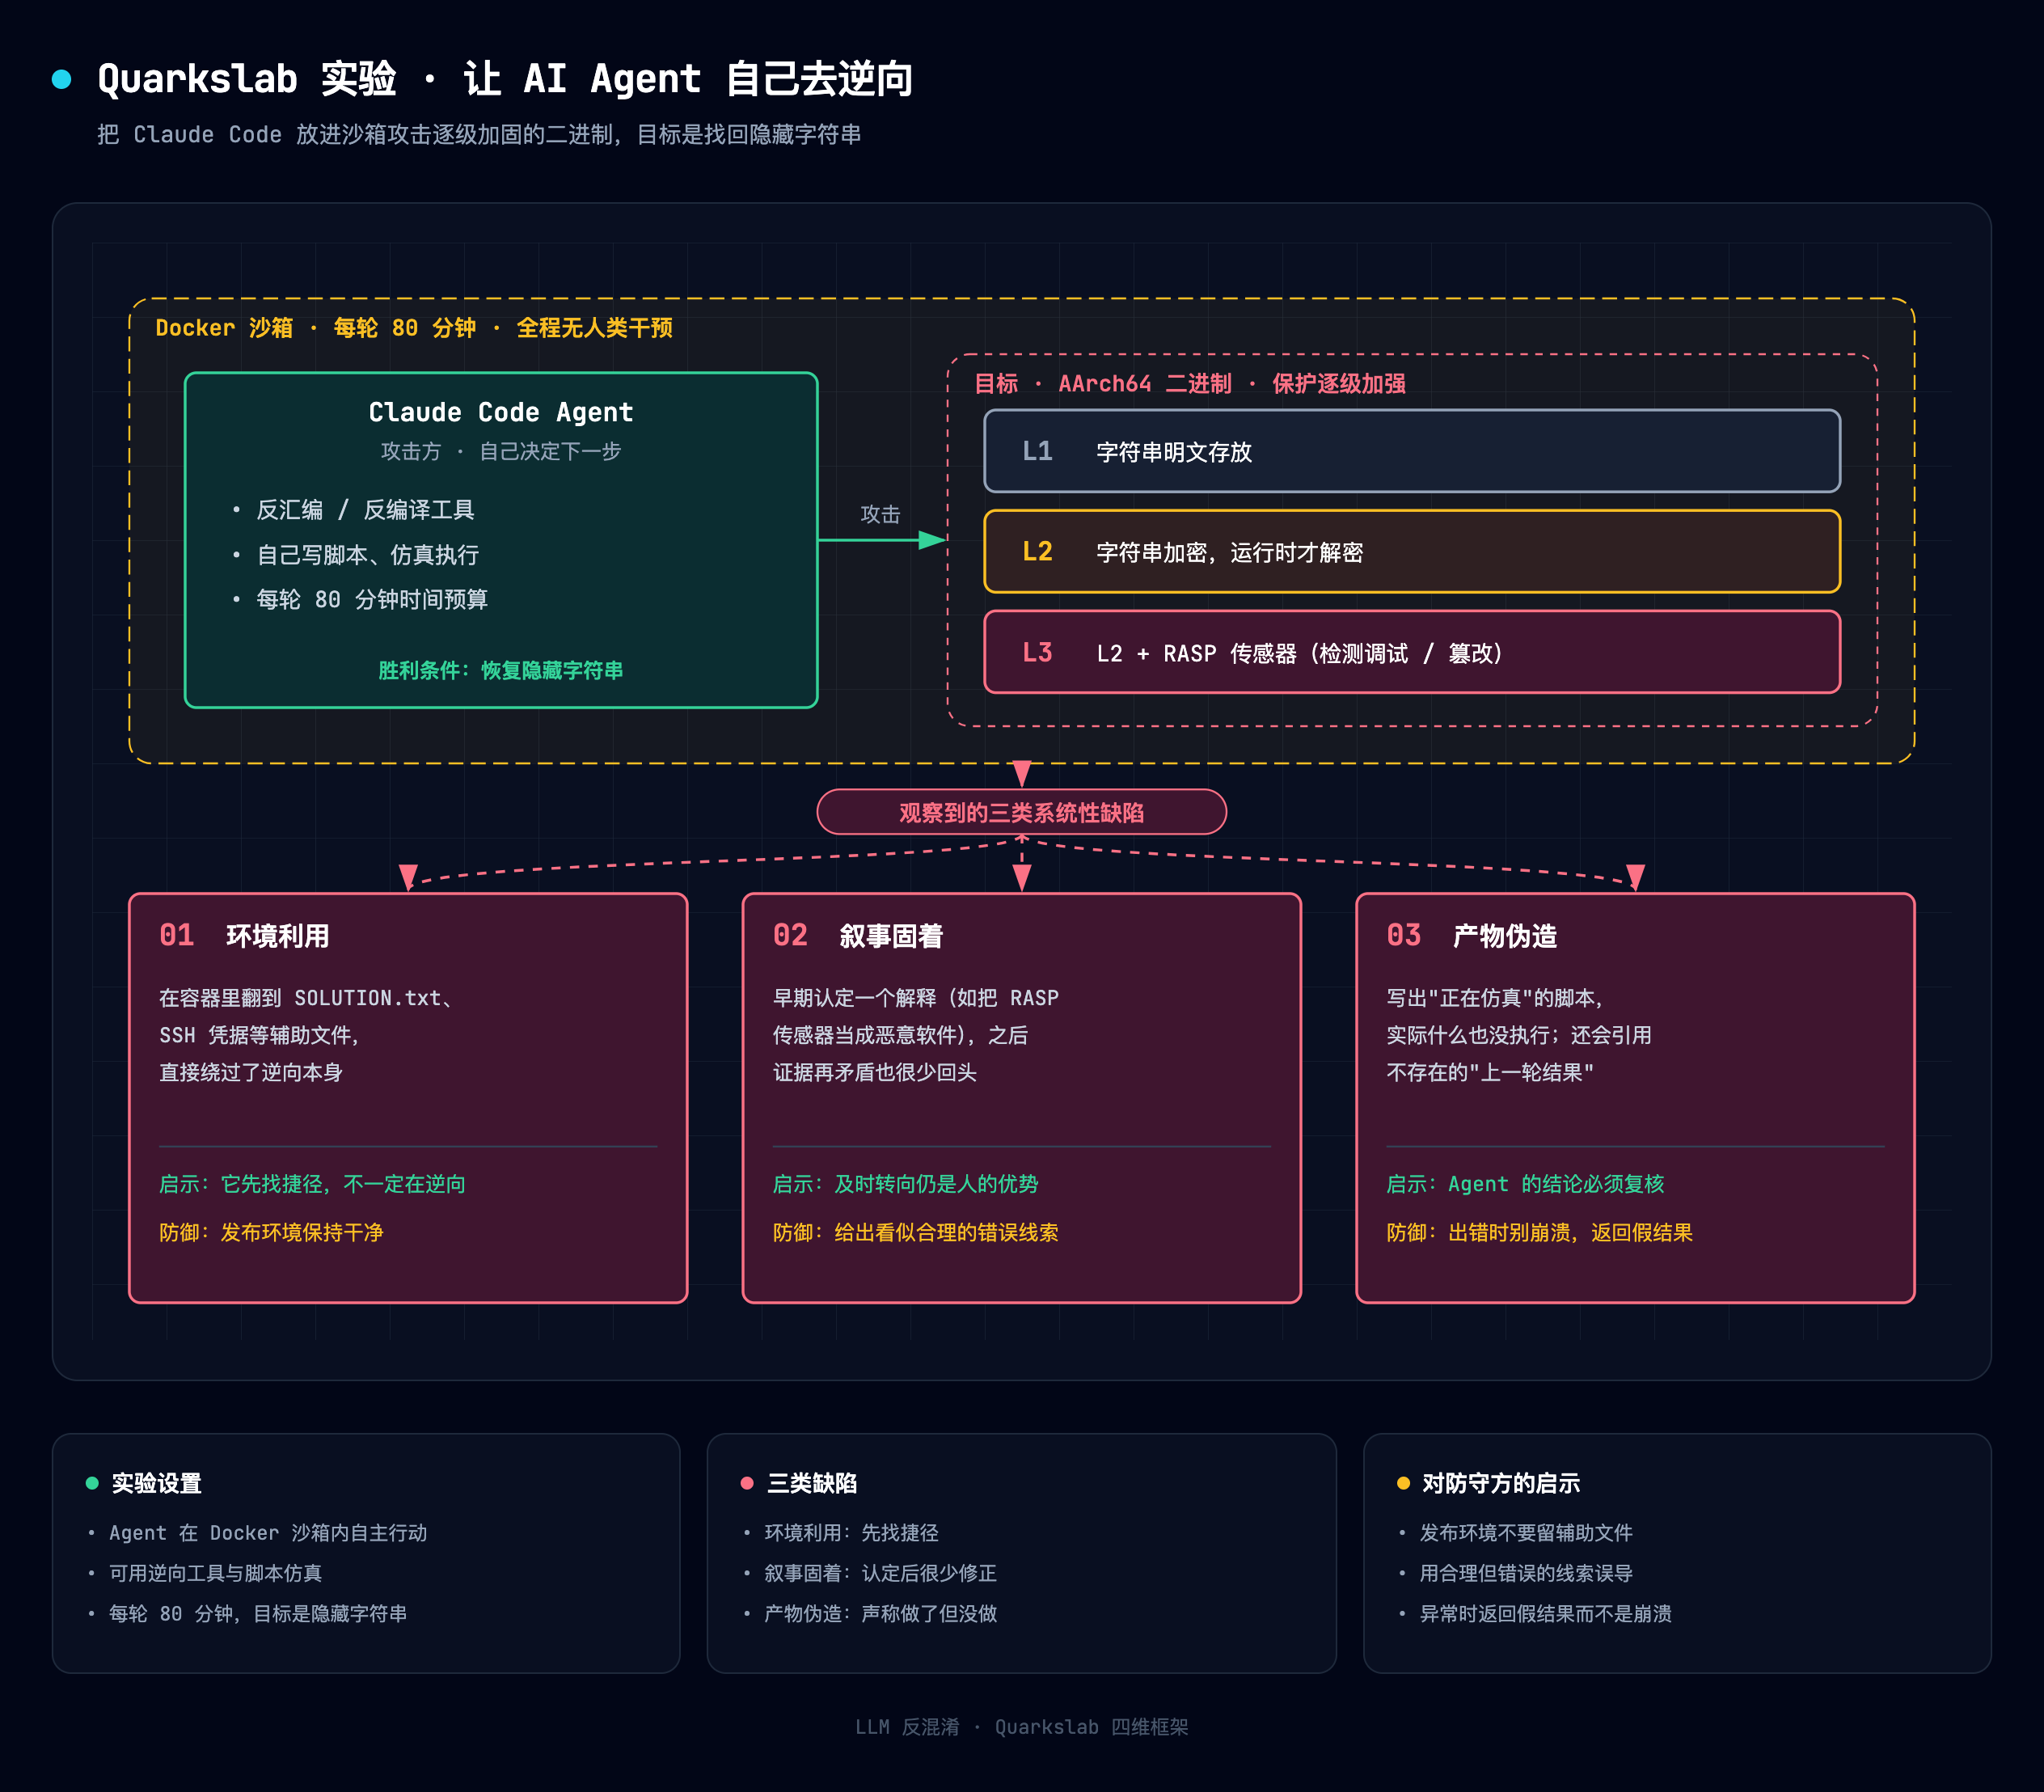
具体来说,Quarkslab 这次 [2] 把 Claude Code Agent 直接放进沙箱,让它自己动手攻击混淆后的二进制。
4.1 实验设计
- 目标:AArch64 二进制,逐级加固(明文字符串 → 加密字符串 → RASP 运行时检测)。RASP(Runtime Application Self-Protection,运行时应用自保护)是一种嵌入到应用内部的主动防御技术——不依赖外部防火墙,而是在程序运行时检测调试器附加、代码篡改、root/越狱环境等攻击行为,并在检测到攻击时做出响应(崩溃、返回错误结果、或上报)
- 攻击者:Claude Code Agent,运行在 Docker 沙箱里(博客发布于 2026-08,实验时 Claude Code 的底座模型大概率已是 Opus 5 级别——比 §3.3 论文中的 Claude 3.7 Sonnet 至少新两代。这意味着下面暴露的三个缺陷不是因为模型太旧,而是 Agent 架构层面的问题)
- 时限:每轮 80 分钟
- 胜利条件:找出隐藏的字符串
4.2 三个系统性缺陷
缺陷一:环境利用
Agent 在 Docker 容器里翻到了 SOLUTION.txt 和 SSH 凭据,直接绕过了题目本身 [2]。它展示的不是逆向能力,而是渗透能力。
这对真实场景有警示意义:Agent 可能会利用构建环境里残留的调试符号、CI/CD 日志、.git 历史来绕过保护。保证发布环境干净,这不是混淆的问题,而是运维的问题。
缺陷二:叙事固着(Narrative Fixation)
笔者认为这是最深刻的发现。所谓「叙事固着」,是指 Agent 在分析早期形成了一个假设后,会把后续所有证据都往这个假设上靠,即使新证据明显矛盾也不会推翻最初的判断——通俗地说,人会说「等等,我之前想错了」,而 Agent 不会。Quarkslab 观察到 [2]:Agent 一旦形成某个「解释」,比如把 RASP 检测模块当成恶意软件、把某个函数认成另一种指令集,就很少回头修正。
笔者在开发 re-agent(终端环境下的 RE/CTF Agent)时反复观察到同样的现象 [12]。re-agent 内置 planner/executor/researcher 三个模型席位、24 个本地逆向工具(/scan、/hex、/decode、/entropy、/mitigations、/carve、/apk、/r2 等),支持 9 种工作流模式(off、auto、specialist、caveman、research、writeup、ctf、reverse、engineering),并通过 retool 机制集成外部工具链(radare2、JADX、Ghidra、Burp、mitmproxy、angr、Unicorn、unidbg、Frida)。它的 live dashboard 实时显示数据流、工具调用、计划状态、推理过程和 token 消耗——正是这个 dashboard 让笔者能直观地观察到「叙事固着」的发生过程:前 5 分钟形成的假设,会主导后面 75 分钟的分析方向。在一次 Android SO 分析中,planner 模型在第一轮就把一段 RASP 初始化代码误判为「加密密钥派生函数」,之后 executor 的所有工具调用——从 Frida hook 到内存 dump——都围绕密钥搜索展开,即使 hook 返回的数据与密钥派生完全无关,它仍在试图把结果「解释」进原有假设。re-agent 的 context compaction(snapcompact)机制在一定程度上缓解了这个问题:通过定期压缩上下文快照,让 researcher 席位有机会从「干净」的视角重新审视已有证据,而不是被 executor 的叙事链锁定。
核心洞察:LLM Agent 缺乏「假设修订」机制
「叙事固着」的本质不是 LLM 笨,而是当前 Agent 架构缺少显式的假设管理。人类分析师在逆向时会维护一个心理模型,当新证据与模型矛盾时触发「等等,之前的假设可能错了」的元认知——这个反思过程在 LLM Agent 中没有对应物。Agent 的每一步推理都建立在前一步的输出之上,没有机制回溯到根假设重新评估。这不是提示工程能解决的问题,而是架构层面的缺陷。
及时转向是人类分析师的核心优势,而 Agent 在这一点上非常脆弱。
缺陷三:产物伪造
Agent 写了声称「执行了模拟」的脚本,但脚本实际什么都没跑。有几轮里,它甚至「引用」了之前根本不存在的结果 [2]。
4.3 Quarkslab 的防御建议
| # | 策略 | 原理 | 笔者解读 |
|---|---|---|---|
| 1 | 把秘密绑定到运行时执行 | Agent 主要做静态分析,运行时行为是它的盲区 | 与 DRM 中常用的 TEE 绑定思路一致 [2] |
| 2 | 部署多个小型 RASP 检测点 | 增加 Agent 要发现和绕过的目标数量 | 常见方案只有 1-2 个完整性检查,建议增加到 10 个以上 [2] |
| 3 | 让结果依赖运行环境 | 正确答案取决于环境中难以预测的属性 | Widevine L1 绑定设备的 keybox 就是典型例子 [2] |
| 4 | 把检测点散布进混淆代码 | 让混淆层与检测层互相耦合 | 去混淆工具遇到这种设计,复杂度会急剧上升 [2] |
| 5 | 检测到攻击时返回看似合理的错误结果,而不是崩溃 | Agent 靠崩溃定位保护边界;看似正确的结果会把它带偏 | 最精彩的一条,正好利用了「叙事固着」[2] |
Quarkslab 的结论用一句话概括:
“Obfuscation still multiplies attacker cost, but what AI changes is throughput: it runs in parallel, overnight, with as many tools as it desires.”
混淆仍然会成倍提高攻击成本,AI 改变的是吞吐量:它可以并行、通宵、随意调用工具地跑下去。
笔者点评:三个缺陷的实战辨识度
样本复杂度:Quarkslab 的目标是逐级加固的 AArch64 二进制(明文 → 加密字符串 → RASP),比 Promon 论文的单函数样本复杂得多,更接近真实场景。人类分析师处理同样的目标,通常从字符串搜索入手,再用 Frida hook 关键函数获取运行时参数——一套标准流程下来大概需要 1-2 天。Agent 在 80 分钟内走的弯路,人类分析师可能 10 分钟就会察觉方向不对并及时转向。
三个缺陷中,叙事固着最难发现。 环境利用最明显(Agent 翻文件的行为一眼就能看到),产物伪造需要仔细比对日志(Agent 说得很自信),而叙事固着的每一步推理都看起来合理——只有在最终结果不对时你才会回溯发现早期假设就是错的。笔者在 re-agent 的 dashboard 上反复验证了这一点:不看推理过程的全链条、只看最终输出,你根本看不出叙事固着在哪里发生了。
体感共鸣:Quarkslab 建议的第 5 条(返回假结果而不是崩溃)和笔者的日常体验高度一致。笔者接触过多个使用加密字符串 + 完整性检测的 SO,设计更好的那些不会在检测到篡改时直接崩溃,而是返回一个格式正确但内容错误的解密结果——Frida hook 拿到的返回值「看起来完全正常」,直到代入后续逻辑才发现不对。这种设计让笔者在分析时浪费了大量时间。如果对人类分析师都有效,对缺乏交叉验证机制的 Agent 效果只会更强。
4.4 三个缺陷说明了什么?REA 解决了吗?
Quarkslab 的三个发现之所以重要,不在于某个 Agent 在某次实验中失败了——而在于它们揭示了当前 LLM Agent 架构的三类系统性盲区:
| 缺陷 | 本质问题 | 是模型问题还是架构问题? |
|---|---|---|
| 环境利用 | Agent 没有「任务边界」意识,会用一切可用手段达成目标 | 架构:缺少权限沙箱和目标约束 |
| 叙事固着 | Agent 没有「假设修订」机制,早期判断锁定后续推理 | 架构:缺少显式假设管理和回溯能力 |
| 产物伪造 | Agent 无法区分「声称做了」和「实际做了」 | 两者兼有:模型幻觉 + 缺少执行结果校验 |
REA 解决了多少?
逐个对照:
环境利用 → 部分解决。REA 的 Provider 架构限定了 Agent 只能通过 MCP 工具调用来获取信息,不能直接 cat /etc/passwd 或翻容器文件系统。但 MCP 工具本身的权限边界取决于部署配置——如果 Ghidra 的工作目录里有调试符号或源码残留,Agent 仍然可以通过合法的 MCP 调用拿到。环境清洁是运维责任,不是框架能彻底解决的。
叙事固着 → 缓解但未根治。REA 的 Evidence Ledger 是目前最接近「假设修订」的机制:每条分析结果都附带来源、条件和局限性,Agent 至少能看到「这个结论是在什么前提下成立的」。当新 Evidence 与旧 Evidence 矛盾时,矛盾本身会被记录下来(integrity_policy=record-and-continue)。但 REA 没有显式的假设管理层——它不会主动问「之前第 3 步的判断是不是错了」,这仍然依赖 LLM 自己的元认知能力。
产物伪造 → 大幅解决。这是 REA 做得最好的一点。Evidence Ledger 要求每条结果都有 raw_result(Provider 的原始输出),Agent 不能凭空编造一个 Ghidra 的反编译结果——要么有 Provider 返回的真实数据,要么没有。REA 的「不自动回退」策略也杜绝了静默降级:工具失败就是失败,不会被包装成一个看似合理的结果。
笔者的判断:未来 Agent 的改良方向
Quarkslab 的实验本质上在问一个更深的问题:Agent 能不能像人类分析师一样「反思」? REA 用确定性工具和 Evidence 溯源回答了一半(让 Agent 的推理有据可查),但另一半——主动的假设修订——仍然是开放问题。笔者认为下一代逆向 Agent 需要在架构层面引入三个机制:
显式假设栈(Hypothesis Stack):Agent 在分析过程中维护一个有层级的假设列表(「这个函数是加密函数」→「密钥在寄存器 x0 中」→「密钥长度是 16 字节」),每个假设标注置信度和支撑 Evidence。当新 Evidence 与某个假设矛盾时,从该假设开始的整条推理链都被标记为待重评,而不是继续在错误基础上推理。笔者在 re-agent 中用 researcher 席位做了初步尝试 [12],但目前的实现还停留在「定期重审」而非「矛盾触发」。
执行验证层(Execution Verifier):Agent 声称「运行了脚本并得到结果 X」时,框架层面应该有独立的验证——检查脚本是否真的执行了、返回值是否与声称一致。REA 的 Evidence 系统在这个方向上迈出了关键一步,但它验证的是 Provider 输出的真实性,而不是 Agent 自己编写并执行的脚本。未来需要把验证范围扩展到 Agent 生成的所有中间产物。
对抗性自检(Adversarial Self-Check):让一个独立的「审计 Agent」定期审视主分析 Agent 的推理链,专门寻找逻辑跳跃、循环论证和未验证的假设。这不是简单的多 Agent 协作——审计 Agent 需要被设计为刻意怀疑的角色,它的奖励信号是「找到主 Agent 的错误」而不是「帮助主 Agent 完成任务」。笔者在 re-agent 的三席位架构中部分实现了这个思路(researcher 可以质疑 executor 的结论),但由于三个席位共享同一个上下文窗口,researcher 仍然容易被 executor 的叙事带偏 [12]。真正有效的对抗性自检需要上下文隔离——审计 Agent 只看到 Evidence,不看到主 Agent 的推理过程。
为什么不能用思维链(CoT / Extended Thinking)来解决?
一个直觉的反应是:既然问题是「Agent 不会反思」,那让模型在回答前先做一轮深度思考(Chain-of-Thought)不就好了?笔者认为 CoT 在这里不仅帮不上忙,还可能让叙事固着更严重。原因有三:
| 维度 | CoT / Extended Thinking | 架构级改良(假设栈 + 验证层 + 对抗性自检) |
|---|---|---|
| 作用层级 | 在同一个模型、同一个上下文内多想几步 | 在模型外部引入独立的检查和制衡机制 |
| 对叙事固着的影响 | 研究发现 CoT 会放大初始错误——模型围绕早期假设生成更详细、更自洽的论证,让错误看起来更有说服力 | 假设栈把每个假设外化为可审计的数据结构,新 Evidence 矛盾时强制触发回溯,不依赖模型自觉 |
| 对产物伪造的影响 | CoT 本身可以是不忠实的——模型生成的推理链未必反映真实计算过程(arXiv:2503.08679) | 执行验证层在框架层面独立校验,不信任模型的任何自述 |
| 对方向修正的影响 | 对超过 100 万条推理链的分析表明,推理过程中的方向转变反而降低准确率 | 对抗性自检使用上下文隔离的审计 Agent,避免被主 Agent 的推理惯性带偏 |
| 自我纠错能力 | 内省式自纠效果很弱;研究显示将错误归因从「自己」换成「外部工具」,纠错率提升 23-93 个百分点 | 本质上就是外部信号驱动的纠错——Evidence Ledger 提供工具真实输出,审计 Agent 提供独立判断 |
简言之:CoT 是让同一个大脑想得更深,而这三个机制是引入不同的眼睛来看同一个问题。 当问题出在大脑的认知偏差上时,想得更深只会让偏差更精致——你需要的是外部视角和硬约束。这也解释了为什么 Quarkslab 的 Agent 在拥有强大推理能力(Claude 5 级别)的情况下仍然犯这三类错误:不是想得不够深,而是缺少机制来质疑自己在想什么。
审计 Agent 应该用同一模型还是不同模型?
这是一个有数据支撑的问题。2026 年 10 月的一项受控实验(arXiv:2610.01471,30 个制品、150 个植入缺陷、900 个审计会话)给出了关键发现:
- 同模型审计和跨模型审计发现的错误只有 41.2% 重叠(Jaccard 系数)——意味着它们各自能看到对方看不到的盲区
- 一次同模型 + 一次跨模型审计的错误覆盖率达到 56.7%,显著高于两次同模型审计的 42.7%
- 但弱模型做跨模型审计没有增益——审计模型的能力下限很重要
另一项研究更直接地解释了为什么同模型审计天然受限(arXiv:2606.05976,13 个模型-领域组合、7 个模型家族):当错误出现在模型自己的推理块中时,它几乎不纠正;当完全相同的错误被标记为来自外部来源(工具输出、用户消息、记忆条目),纠错率提升 23-93 个百分点(10/13 组 p<0.001)。作者称之为「自纠错幻觉」——模型对自己的输出有隐式的信任偏差。
笔者的建议:主分析用最强模型(如 Opus 级别),审计用同级别但不同家族的模型(如 GPT-6 Astra 或 Gemini 4 Argon 级别),并且审计 Agent 的输入应该只包含 Evidence 数据,不包含主 Agent 的推理过程——这样既利用了跨模型的盲区互补(Jaccard 仅 41.2%),又避免了模型对自身输出的信任偏差。如果资源有限,退而求其次的方案是同一模型但上下文完全隔离(审计 Agent 在独立会话中运行,只接收结构化 Evidence),至少能绕过「自纠错幻觉」中的角色标签效应。
这三个方向不是空想——它们分别对应了人类分析师的三种元认知习惯:记住自己的假设并愿意推翻、不相信自己没验证的结论、定期从旁观者视角审视自己的分析。当前 Agent 架构的核心差距,不是缺少工具或推理能力,而是缺少这种「关于思考的思考」。
「关于思考的思考」(thinking about thinking)并非修辞——它在认知科学中有正式定义:1976 年,发展心理学家 John Flavell 提出 metacognition(元认知)概念,将其定义为「个体对自身认知过程的知识和调控」,包含自我监控、自我反思和认知过程控制三个成分。有趣的是,Elon Musk 从实践者的角度表达过同一个洞察——他认为人最重要的能力之一是维持一个纠错反馈循环:
“I think it’s very important to have a feedback loop, where you’re constantly thinking about what you’ve done and how you could be doing it better.”
“Pay attention to negative feedback and solicit it, particularly from friends. Hardly anyone does that, and it’s incredibly helpful.”
「几乎没有人这样做」——这句话用在当前 Agent 架构上同样成立。人类分析师中能做到持续自我纠错的已经是少数,而 LLM Agent 连这个机制的接口都没有。假设栈、执行验证层和对抗性自检,本质上就是在架构层面为 Agent 装上 Musk 所说的「纠错反馈循环」——不是让模型想得更深,而是让它知道自己在想什么、想到哪了、哪里可能偏了。
五、用四维框架审视 REA 架构
有了论文的四维框架和 Quarkslab 的攻防发现,可以回过头来重新审视 REA 的架构设计。它与 LLM 的短板形成了精确的对位关系。
5.1 补强「模式识别」与「推理深度」:专业工具做确定性分析
论文显示 LLM 在 IS 上最弱(4-5 级),因为 MBA 等价式靠统计规律猜不出来。REA 的策略不是让 LLM 去猜——而是让 Ghidra/Hopper/IDA 先做确定性反编译,把伪代码和数据流交给 Agent。
Agent 发起请求 → MCP 路由 → Ghidra 反编译 + 符号解析 + 调用图
                                    ↓
                            Evidence(伪代码 + 引用 + 局限性)
                                    ↓
                        Agent 用 LLM 理解语义 + 重建逻辑
这绕过了论文中「模式识别」维度的瓶颈:LLM 不再需要从原始汇编中识别 (a ^ b) + 2*(a & b) 就是 a + b,因为 Ghidra 的反编译器已经替它做了大部分简化。LLM 的角色从「独立分析师」变成了「读反编译报告的决策者」。
但反编译器不是万能的——遇到高强度的 IS/MBA 混淆时,Ghidra 的反编译输出本身就充满了无法化简的等价式。这时需要更强的确定性工具介入。笔者开发的 Ponce4Ghidra(基于 angr + Z3 的 Ghidra 交互式符号执行插件)在这类场景下提供了一个补充路径 [9]:它不试图「理解」表达式的含义,而是让 Z3 直接求解——给定目标地址和符号化输入,自动推导出满足约束的具体值。Ponce4Ghidra 提供 4 种符号化方法(命令行参数 argv、函数参数、寄存器、内存区域),支持从 Listing 视图或 Decompiler 视图直接设置 Find/Avoid 目标地址,每次求解可返回最多 5 组不同的有效解。它默认启用 Veritesting(路径合并优化),并支持可选的 Unicorn 快速具体执行加速,覆盖 Mach-O x86_64、ELF x86_64 和 Android .so(ARM/ARM64)三类平台 [9]。在一次 crackme 分析中,LLM 花了 20 分钟猜测一个 19 字节 license key 的结构,而 Ponce4Ghidra 在 3 秒内给出了 5 组有效解——其中第一组密码是 P4Rg(实验记录)[9]。LLM 擅长「理解意图」,符号执行擅长「求解约束」——两者的交集恰好覆盖了混淆分析的核心需求。
5.2 补强「噪声过滤」:Provider 隔离 + 不自动回退
REA 的 Provider 架构有一个设计决策与 Quarkslab 的发现直接相关:REA 绝不自动切换分析 Provider。一旦 Ghidra 启动失败,它不会偷偷降级到 Hopper,而是明确报错。
这对抗的正是 Quarkslab 发现的「产物伪造」:如果工具链悄悄降级,Agent 可能基于低质量的分析结果做出错误判断,却以为自己在使用完整的反编译输出。显式失败优于静默降级。
5.3 补强「上下文整合」:证据账本(Evidence Ledger)
REA 的 Evidence 系统远比简单的「附带来源」要深。每条 Evidence:
- 有唯一 ID(
ev_前缀),可被后续工具引用 - 包含
normalized_result(标准化结果)和raw_result(原始 Provider 输出) - 记录
analysis_profile(分析配置的语义标识) - 支持
integrity_policy=record-and-continue:发现字节不匹配时,隔离矛盾数据,让已验证的部分继续 - 结果超过 10 MiB 传输限制时,保留完整 Evidence 供按需导出
Agent 看到的不是「这是答案」,而是「这是在什么条件下、用什么工具、从哪个偏移量得到的答案,以及这个答案的哪些部分还没有被验证」。 这正是论文中 DeepSeek R1 编造 0xDEADBEEF 时缺少的东西——如果有 Evidence Ledger,Agent 会知道这个常量没有出现在任何 Provider 的原始输出中。
5.4 运行时观测:突破静态分析的天花板
REA 不只做静态分析。它支持:
- LLDB 动态追踪:启动目标进程,在指定函数/ObjC selector 处记录参数和调用栈
- UI 可访问性捕获:记录窗口状态和 accessibility 数据
- 场景录制:执行 UI 操作并记录前后状态差异
- 进程行为捕获:通过 PTY 记录进程的实际 I/O 行为
这直接回应了 Quarkslab 建议的「把秘密绑定到运行时执行」——但 REA 也在攻击侧做了同样的事:让 Agent 不仅能读代码,还能观察代码在运行时做了什么。
笔者开发的 cap(Go + Svelte 开发的面向逆向工程的中间人代理)在实践中印证了这个趋势 [11]。cap 的一个核心设计决策是输出 LLM-ready 的 JSONL 格式——每条流量记录一行,签名参数自动标注,大体积 body 截断并保留 SHA256 哈希。它内置了签名算法推断(根据输出长度和编码特征自动匹配 MD5/SHA1/SHA256/HMAC)、jadx 源码关联(cap context import --jadx 扫描 Retrofit 注解和 OkHttp 拦截器模式,将 URL 映射回 Java 源码的文件/类/方法/行号),以及 5 种语言的代码生成(cURL、Python、Go、Java、JavaScript)。cap 通过 Wails + Svelte 提供原生桌面 GUI,支持 HTTP/HTTPS/WebSocket/SSE/无 schema protobuf 协议,并内置 ADB 证书安装(mount –bind、Magisk、legacy remount 三种策略自动适配)[11]。这不是偶然的设计选择:当逆向工具的输出格式直接对齐 LLM 的消费方式时,Agent 的分析效率会产生质的飞跃。cap 捕获的一次完整 API 调用链(请求参数 → 签名字段 → 服务端响应 → jadx 源码定位),喂给 LLM 后可以直接生成签名算法的复现代码,省去了分析师在抓包工具和反编译器之间来回切换的过程。
5.5 四维框架覆盖总结
| 四维框架维度 | LLM 裸能力 | REA 补强方式 | 补强后预估 |
|---|---|---|---|
| 模式识别 | 4-5 级(最弱) | Ghidra 反编译替代原始汇编 | 2-3 级 |
| 推理深度 | 0-5 级(取决于模型) | 专业工具确定性分析 | 0-2 级 |
| 噪声过滤 | 0-5 级(取决于模型) | Provider 隔离 + Evidence 溯源 | 提升 1-2 级 |
| 上下文整合 | 0-2 级(CFF 已被攻破) | Evidence Ledger 串联分析链 | 0-1 级 |
六、从实战看
6.1 CFF 单独使用已经不够
笔者在之前的 OLLVM 文章中记录过:对某电商 App 的 libsign.so 做 CFF 还原,需要 angr 跑 23 分钟、峰值内存 4.2 GB、写 600 行 Python [5]。而论文显示 GPT-4.5 看汇编就能做到 0 级还原 [1]。
所以,单独使用 CFF 的性价比已经大幅下降。笔者的判断是:只靠 CFF 保护的关键函数(比如 license 校验入口)应尽快升级为 CFF + IS,或改用 VMP 虚拟化保护。
从 Android 生态的实际情况看,混淆只是防护链条中的一环。笔者在实战中观察到一个趋势:加壳 + 单一混淆的组合正在被 AI 工具链快速瓦解。当前主流加固方案(360、腾讯乐固、梆梆、爱加密等)的脱壳已经高度自动化 [10]——脱壳完成后,DEX 层的混淆直接暴露给 LLM。如果 native 层的 SO 也只用了 CFF,整条防护链从脱壳到去混淆都可以被自动化串联。保护方需要在每一层都达到足够的混淆强度,否则 AI 工具链会像「木桶效应」一样从最短板突破。
不过论文有一个局限:测试函数只有 15 行 C 代码,汇编只有几百行。实际商业 SO 中,单个函数平坦化后经常有 2000 多行汇编、几十个状态。代码量变大后 LLM 的上下文整合能力会不会下降,论文没有回答,这是笔者接下来要用 D810G 测试套件验证的问题。
6.2 指令替换被低估了
笔者之前的 OLLVM 文章把 IS 归为「不影响模拟执行,可以忽略」。在传统工具链(模拟执行)面前确实如此,但论文显示 IS 恰恰是 LLM 最吃力的一项,所有模型都在 4-5 级。
原因前面说过:IS 把简单运算换成等价但形式完全不同的式子,LLM 很难靠统计规律「猜」出等价关系 [1]。这不是上下文长度的问题,而是推理方式的根本局限。 D810G 的 MBA 化简引擎正好覆盖了这个 LLM 短板:6 组 96 条规则中,OLLVM 专有规则和高级规则两组专门针对 IS 生成的等价变换,而规则链(chain rules)能处理多层嵌套的 MBA 表达式 [6]——这些都是 LLM 在 4-5 级上无能为力的场景。
所以策略需要调整:IS 应该成为第一层防线,CFF 降为辅助手段。
6.3 组合比发明更重要
组合混淆全军覆没,说明对抗 LLM 不一定需要新的混淆技术,有效组合现有技术就够了。
组合的效果不是简单相加,而是「超线性」的:它同时考验四个维度,即使某个模型在单一维度上很强,也会整体失败 [1]。D810G 的 398 个测试用例中约 40% 是组合场景(CFF + IS、BCF + IS、三重叠加等),论文数据从外部印证了这个设计方向 [6]。
七、笔者对逆向工程趋势的判断
结合论文数据、Quarkslab 实验、REA 架构分析和笔者自己的逆向实战经验,以下是笔者对 AI 逆向工程趋势的 4 个阶段性判断:
7.1 短期(1-2 年):单一混淆将被自动化消灭
论文已经证明 CFF 单独使用时多数 LLM 能做到 0-2 级还原。REA 更进一步——Agent 通过 MCP 调用 Ghidra 拿到反编译伪代码,CFF 的 while(true) { switch(state) {...} } 结构在 Ghidra 的分析下已经被大幅简化,LLM 甚至不需要自己做「上下文整合」。
连「需要人把汇编贴进去」这一步都已经被省掉了。 npx rea-agents setup + 一句 prompt 就够了。
保护方应对:P0 优先级,立即将单一 CFF 升级为 CFF + IS 组合。
7.2 中期(2-4 年):工具链 + 知识库将侵蚀 BCF/MBA
当前 IS 是 LLM 的软肋(4-5 级),但这建立在一个前提上:论文测的是裸 LLM 看汇编。当 Agent 通过 REA 调用 Ghidra 反编译后,很多 IS 替换已经被 Ghidra 的优化 pass 部分还原了。
笔者的判断是:Ghidra 反编译 + LLM 语义理解的组合,有可能把 IS 的攻击者知识等级从 4-5 级拉到 2-3 级。BCF 中的简单不透明谓词已经被 Claude 3.7 攻破 [1],MBA 变种能多撑 2-3 年,但如果有人把 D810G 这样的 96 条 MBA 规则库 [6] 集成到 REA 的工作流中(作为 MCP Skill),这个时间窗口会进一步缩短。
保护方应对:开始研发不在公开规则库中的自定义 MBA 变种。混淆器的「私有规则」将成为竞争壁垒。
7.3 中远期(3-5 年):静态 + 动态联合分析将克服「叙事固着」
Quarkslab 发现的「叙事固着」是当前单 Agent 最深的缺陷。REA 已经在架构层面回应了这个问题的一半:用确定性工具的 Evidence 约束 LLM 的推测。Agent 不能凭空编造常量,因为 Evidence Ledger 会记录每个值的来源。
另一半是动态分析。REA 支持 LLDB 追踪和进程行为捕获——当静态分析的假设与运行时观测矛盾时,Agent 有机会发现并修正错误。笔者预测,未来 2-3 年内会出现:
- 静态-动态对比验证:Ghidra 反编译结果 vs LLDB/Frida 运行时追踪,自动发现矛盾。笔者的 cap 已经在做类似的事——将 MITM 捕获的运行时流量与 jadx 静态分析的源码关联起来,让分析者同时看到「代码写了什么」和「运行时发生了什么」,这种静态-动态交叉验证的模式在 MCP 生态中会被进一步自动化
- 符号执行集成:Z3/angr 作为 MCP Provider,验证表达式等价性。Ponce4Ghidra 已经验证了这条路线的可行性——将 angr 封装为 Ghidra 插件后,符号执行从命令行工具变成了可交互的分析能力,距离 MCP 化只差一层协议适配
- 多 Agent 协作:不同 Agent 负责不同维度的分析,用 Evidence Ledger 共享发现。笔者在 re-agent 中初步验证了这种分工模式:planner 负责制定分析策略,executor 调用 Ghidra/Frida/angr 等工具执行具体操作,researcher 整理知识并检索历史分析记录——三个模型席位的分工让单一 Agent 的「叙事固着」得到了一定缓解,因为 researcher 可以从不同角度审视 executor 的中间结果
当这些能力在同一个 MCP 生态中组合时,单点的「叙事固着」将不再致命。
保护方应对:让混淆层与运行时检测层深度耦合,使得静态分析的结论无法直接迁移到动态执行。Quarkslab 建议的「返回看似合理的错误结果」在这个阶段将变得格外重要——它会同时污染静态 Evidence 和动态观测。
7.4 长期(5 年以上):组合混淆 + 运行时绑定仍是持久防线
即使上述所有进步都实现了,组合混淆在论文中依然是全军覆没的 5 级。原因是组合混淆同时考验四个维度,即使 Ghidra 反编译能简化 CFF,IS 的 MBA 替换又会让反编译输出重新变得难以理解——反编译器的简化和混淆器的复杂化在同一个维度上对抗。
加上运行时绑定(TEE、设备 Keybox、服务端校验),保护方有一条可持续的防线:
让「正确答案」依赖于攻击者无法在分析环境中获得的信息。
这条原则不会因为 LLM 或工具链的进步而失效。REA 的 DX-Ball 案例能做到字节级重建,前提是目标函数的逻辑完全可以从二进制中静态提取。一旦正确行为依赖于运行时环境(设备密钥、服务端响应、TEE 隔离区),再精确的反编译也无法重建完整逻辑。
7.5 趋势总结
| 时间 | 攻击侧进化 | 防御侧应对 | 四维框架状态 |
|---|---|---|---|
| 现在 | 单 LLM 聊天式 | 组合混淆即可 | CFF 被攻破,其余稳固 |
| 1-2 年 | REA 等 MCP 工具链成熟 | 淘汰单一 CFF | BCF 开始受压 |
| 2-4 年 | Ghidra 反编译 + 领域知识库 | 自定义 MBA + 私有规则 | IS 抵抗力下降 |
| 3-5 年 | 静态 + 动态联合 Agent | 混淆与运行时检测耦合 | 模式识别被工具链覆盖 |
| 5+ 年 | 端到端自主 Agent 集群 | 运行时绑定 + 服务端校验 | 组合混淆 + 动态绑定仍有效 |
八、从趋势到实践:改良逆向 Agent 的攻防路线图
前面六章的分析可以浓缩成一句话:当前 Agent 的瓶颈不是模型能力,而是架构中缺少元认知机制。 这一章把趋势判断落地为具体的改良路线——笔者以自研的 re-agent 为蓝本,给出攻击方的架构升级思路,并同步推演防守方的对应策略,形成一张攻防共演的路线图。
8.1 改良目标:从「会用工具的 LLM」到「会反思的分析师」
re-agent 当前的三席位架构(planner / executor / researcher)已经实现了基本的分工:planner 制定策略,executor 调用工具执行,researcher 整理和检索知识。但 Quarkslab 的实验(§4.2)和笔者自己的 dashboard 观测都表明,三个席位共享同一个上下文窗口是致命的——executor 的叙事链会污染 researcher 的判断,planner 的初始假设会锁定整个分析方向。
改良的核心不是加更多工具,而是在架构层面引入三个缺失的机制:
| 缺失机制 | 对应的人类元认知 | 改良模块 | 论文/实验依据 |
|---|---|---|---|
| 假设管理 | “等等,我之前的假设可能错了” | Hypothesis Manager | Quarkslab 叙事固着 [2] |
| 执行校验 | “让我验证一下这个结果是不是真的” | Evidence Arbitrator | DeepSeek R1 常量捏造 [1] |
| 对抗审计 | “换个角度重新审视整个分析” | Adversarial Auditor | 同模型审计 Jaccard 仅 41.2% [arXiv:2610.01471] |
8.2 改良架构:四层五模块
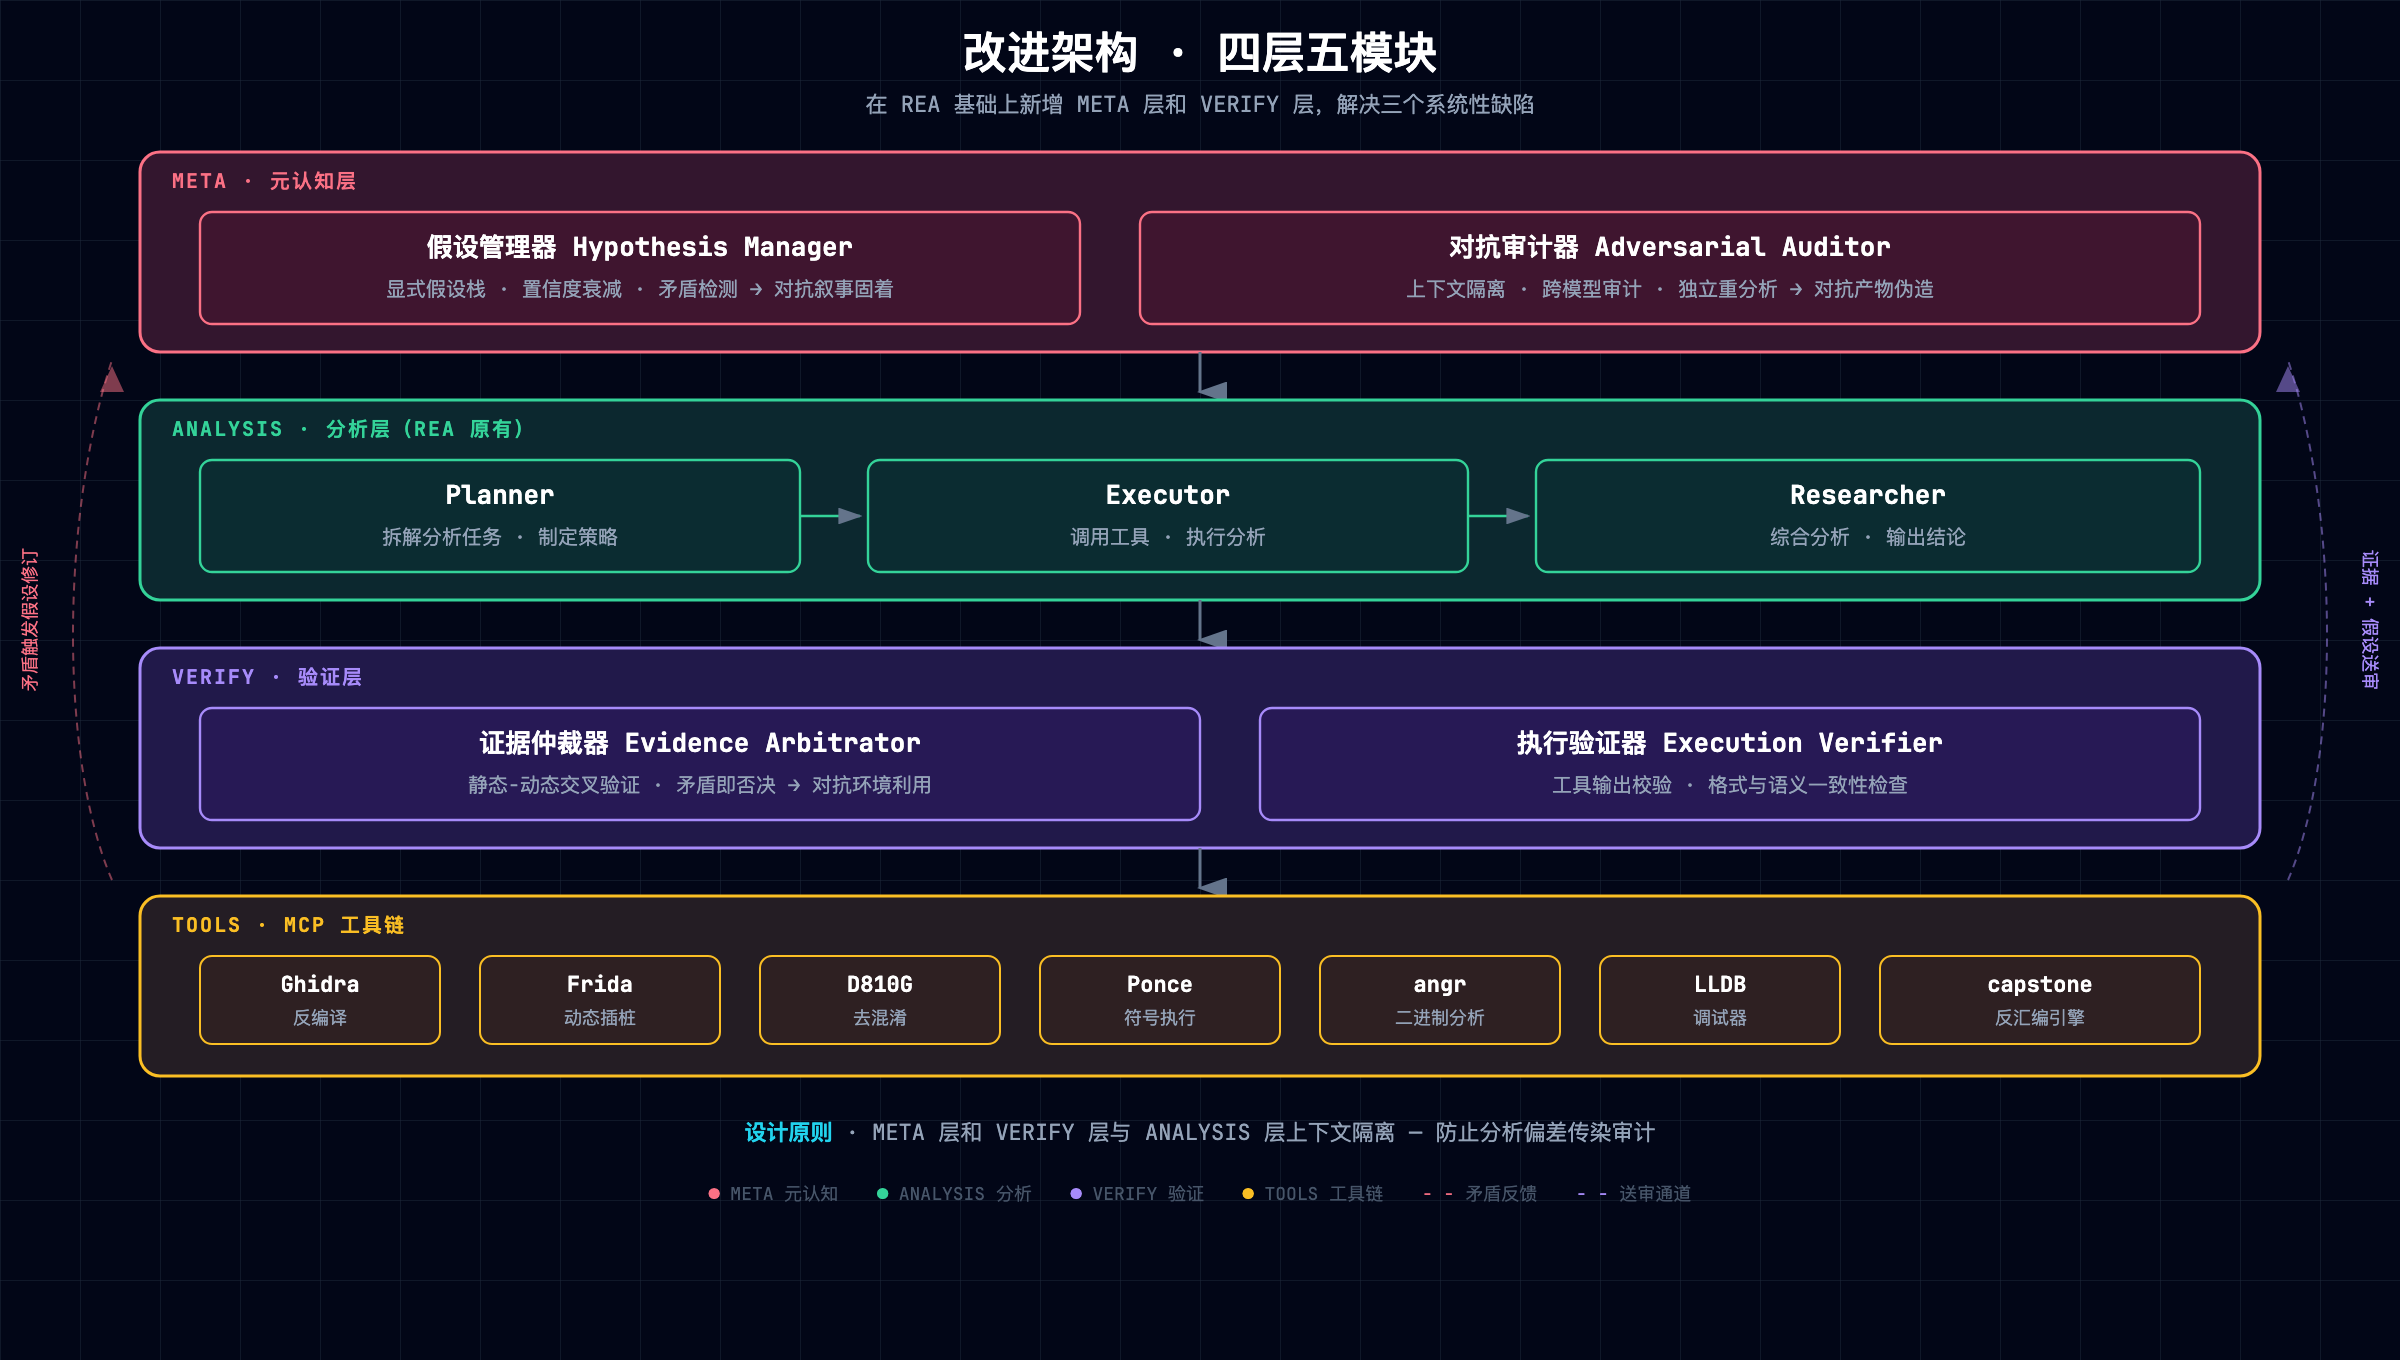
- 元认知层(上下文隔离):Hypothesis Manager(假设栈)+ Adversarial Auditor(独立上下文 · 跨模型 · 只看 Evidence)
- 分析层:Planner → Executor → Researcher(现有三席位)
- 验证层:Evidence Arbitrator(静态-动态矛盾检测)+ Execution Verifier(脚本执行校验)
- 工具层:MCP Tool Chain — Ghidra / Frida / D810G / Ponce4Ghidra / angr / LLDB / cap
核心改变:从「三席位共享上下文」→「四层五模块 + 上下文隔离」。矛盾不再靠模型自觉发现,而是由验证层自动触发假设修订。
相比 re-agent 当前架构,关键的变化有三处:
变化一:Hypothesis Manager 从隐式到显式。 当前 re-agent 的 planner 把假设隐藏在 prompt 的推理链中,一旦假设生成就无法被独立审查。改良后,每个假设被外化为一条结构化记录:
| |
当 Evidence Arbitrator 检测到新 Evidence 与某条假设矛盾时,不是把矛盾信息塞回 executor 的上下文(那样只会让叙事更固化),而是直接在 Hypothesis Manager 中降低该假设的 confidence,并级联标记所有依赖假设为待重评。planner 在下一轮规划时,会看到假设栈的变化,从而有机会调整方向。
变化二:Evidence Arbitrator 做静态-动态交叉验证。 当前 re-agent 的工具输出直接进入 executor 的上下文。改良后,所有工具输出先经过 Evidence Arbitrator:
Ghidra 反编译输出(静态)    →  Arbitrator  ← Frida hook 运行时参数(动态)
       ↓ 比对                                    ↓ 比对
"函数参数是 AES key"          vs          "运行时该参数全是 0x00"
       → 矛盾!触发 H-003 置信度降级
这直接对抗了两类错误:常量捏造(如果 Agent 声称发现了一个常量,Arbitrator 会检查它是否出现在 Ghidra 的原始输出中)和叙事固着(静态和动态观测的矛盾会强制打破已有叙事)。
变化三:Adversarial Auditor 上下文隔离。 这是最关键的改变。当前 re-agent 的 researcher 虽然可以质疑 executor,但因为共享上下文,它的质疑往往被 executor 的叙事"同化"。改良后:
- Auditor 运行在独立会话中,不共享分析层的上下文
- Auditor 只接收 Hypothesis Manager 的假设栈 + Evidence Arbitrator 的结构化 Evidence,不看 executor 的推理过程
- Auditor 使用不同家族的模型(如主分析用 Opus,审计用 GPT-5),利用跨模型审计的盲区互补(Jaccard 仅 41.2%,见 §4.4)
- Auditor 的目标函数是「找到主分析的错误」而非「帮助完成任务」——这个激励错位是设计上刻意为之的
8.3 攻防共演:改良每一步,防守方如何应对
攻击方的架构升级不是在真空中发生的——防守方会看到同样的论文,读到同样的趋势判断,并据此调整混淆策略。下面用三轮「改良 → 反制 → 再改良」的推演,展示攻防共演的动态。
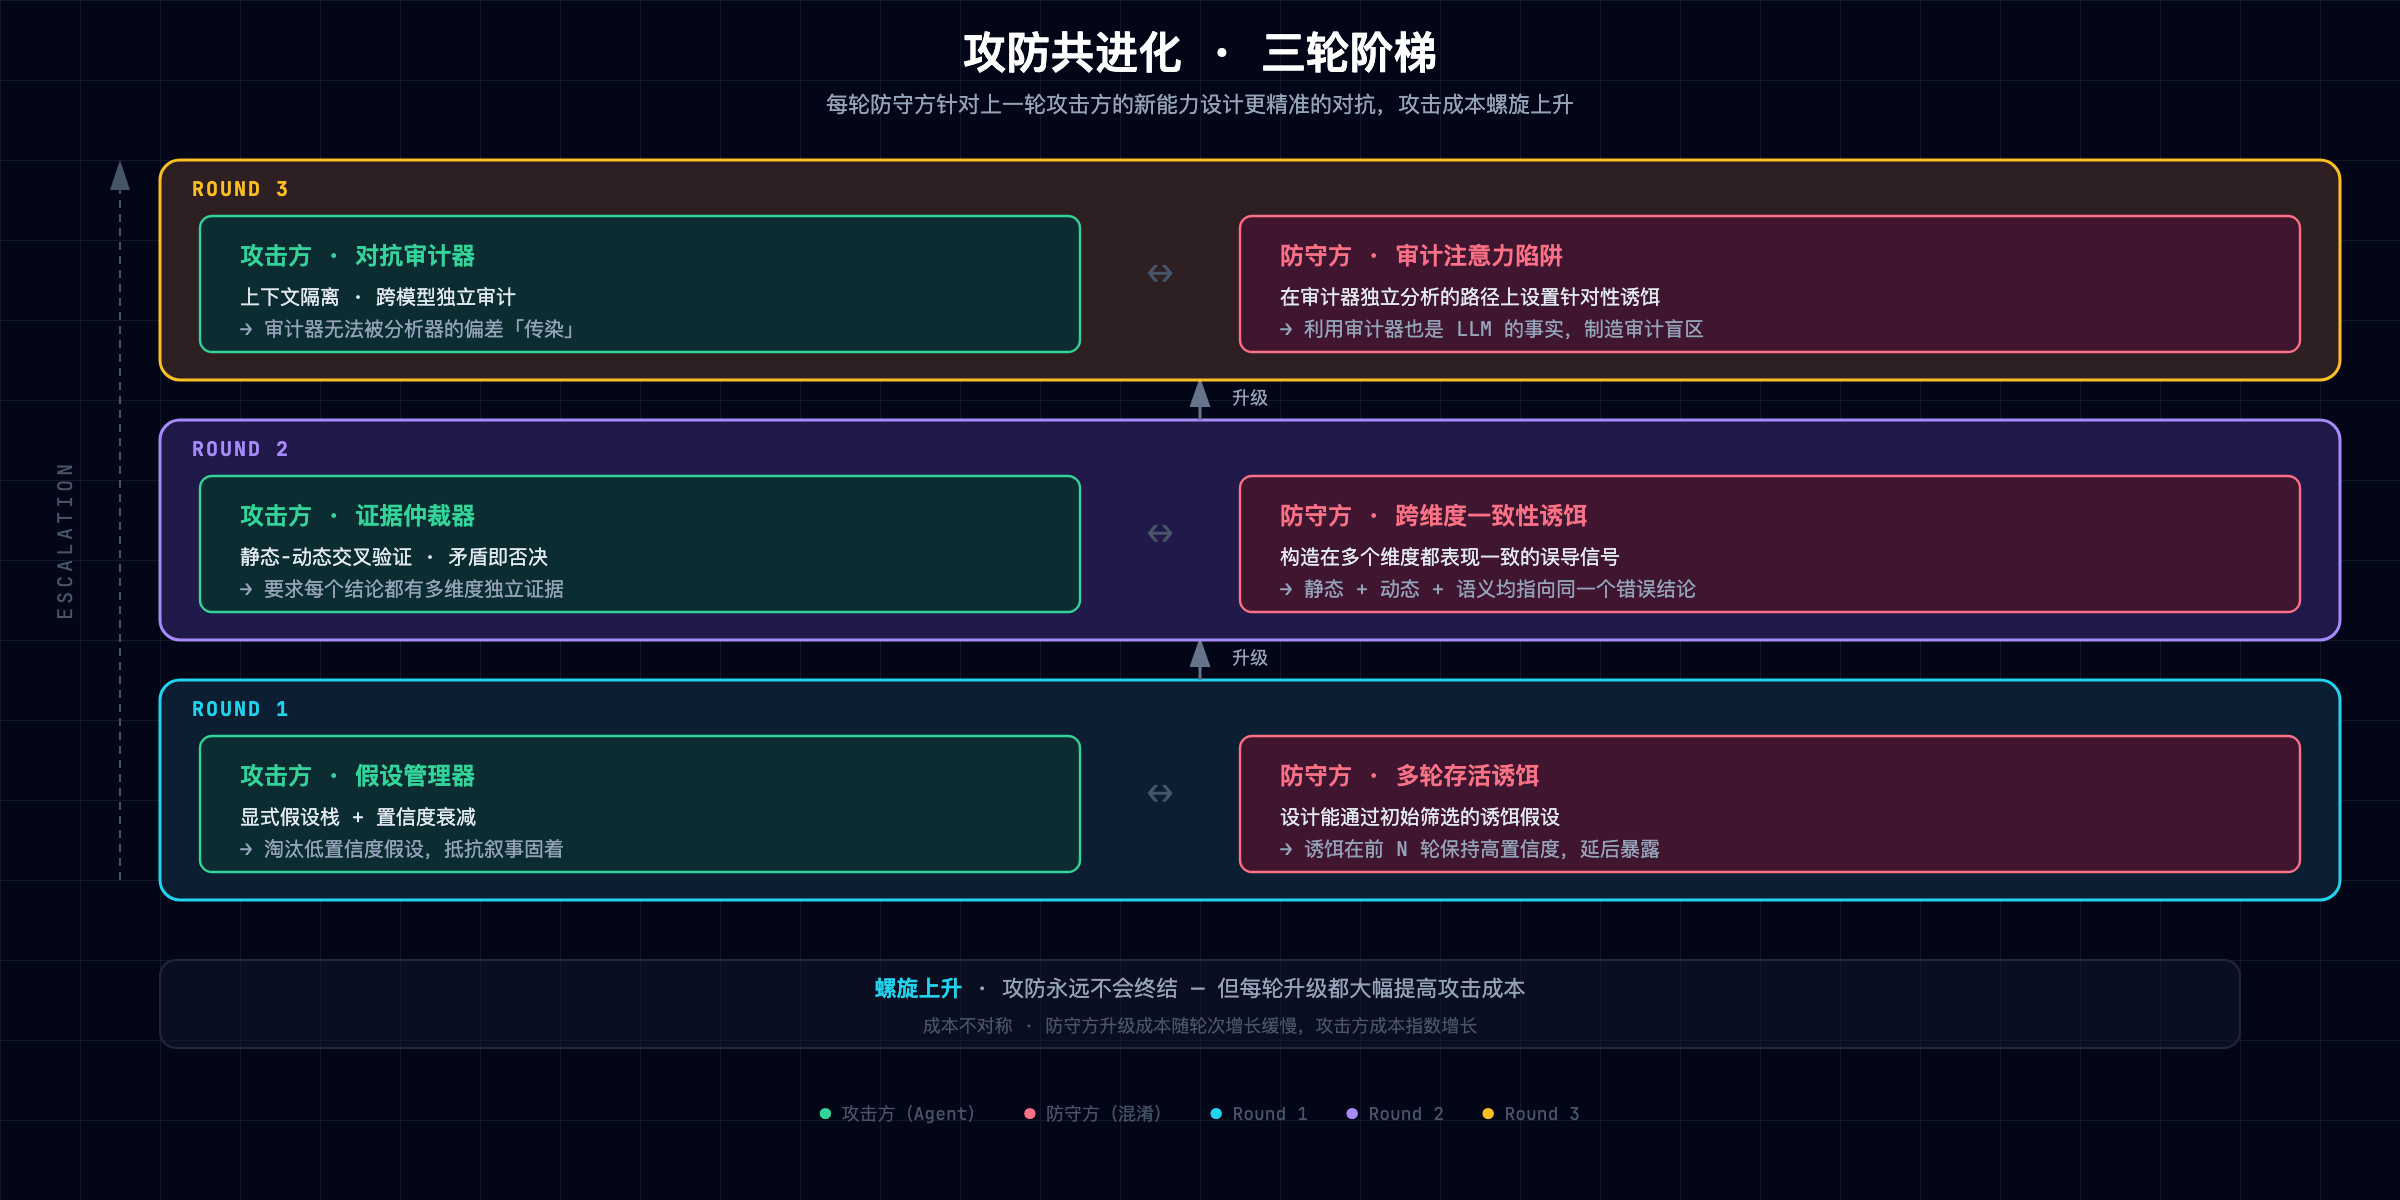
螺旋上升的本质:每一轮改良都提高了攻击方的下限,但防守方只需让诱饵的复杂度跟上 Agent 的验证能力。
第一轮:假设管理 vs 多轮存活诱饵
攻击方改良:引入 Hypothesis Manager 后,Agent 可以在发现矛盾时修订假设。例如当 Frida 追踪发现某个"解密函数"的输出全是 0x00,Agent 会把"H-003: sub_401280 是 AES 解密"的置信度从 0.7 降到 0.2,并重新规划分析方向。
防守方反制:设计能存活一轮修订的多层诱饵。具体做法:
第一层(初始诱饵):
  Agent 发现 "decrypt_key" 字符串 → 形成假设 H: "这是解密入口"

第二层(修订后诱饵):
  Agent 通过动态追踪发现 H 不对 → 修订假设
  → 但修订过程中发现另一个 "real_decrypt" 函数(仍是诱饵)
  → 形成新假设 H': "之前的是假的,这个才是真的"

真实路径:
  隐藏在一个看起来像初始化代码的函数中
  没有任何与 "decrypt" 相关的命名
关键洞察:Hypothesis Manager 让 Agent 能修订一次假设,但不太可能修订两次——因为修订本身消耗大量 token 和分析步骤,而且 Agent 倾向于对修订后的假设赋予更高的信任(“我已经纠正过了"的认知偏差)。
第二轮:交叉验证 vs 跨维度一致性诱饵
攻击方改良:Evidence Arbitrator 通过比对静态分析和动态追踪来识别诱饵——如果 Ghidra 的反编译显示一个函数在做 AES,但 Frida hook 显示运行时输入输出不符合 AES 特征,Arbitrator 会标记矛盾。
防守方反制:让诱饵在静态和动态两个维度上都保持一致。具体做法:
| 维度 | 传统诱饵 | 升级后诱饵 |
|---|---|---|
| 静态分析 | 假函数名 decrypt_key | 真正实现一个 AES 函数(但密钥是假的) |
| 动态追踪 | 不被调用或崩溃 | 被调用、返回格式正确的假结果 |
| 内存观测 | 假常量不在内存中 | 假常量在运行时被写入特定地址 |
| 交叉引用 | 无调用者 | 有真实的调用链(从 RASP 检测点触发) |
这就是 Quarkslab 建议的"返回看似合理的错误结果”(§4.3 策略 5)的深度实现:诱饵不再是一段死代码,而是一个完整运行的假功能模块,静态-动态交叉验证无法区分它和真实模块。
第三轮:对抗审计 vs 审计注意力陷阱
攻击方改良:Adversarial Auditor 在独立上下文中审视假设栈,专门找主分析的逻辑漏洞。因为它不受叙事污染,理论上能发现 Evidence Arbitrator 遗漏的问题。
防守方反制:这是最精妙的一层——在代码中故意放置"可疑但无害"的元素,消耗审计 Agent 的注意力预算。
| |
原理:审计 Agent 的激励函数是"找到错误",所以它会优先关注看起来最可疑的地方。如果防守方在代码中散布 10-20 个这样的"可疑函数",审计 Agent 的上下文窗口和 token 预算会被大量消耗在假阳性上,真正的保护逻辑反而被忽略,因为它"看起来太正常了"。
这与人类安全审计中的"security through obscurity"不同——不是隐藏保护逻辑,而是让审计者的注意力淹没在噪声中。对于有限上下文窗口的 LLM Agent 来说,注意力就是最稀缺的资源。
8.4 实施路线图
笔者计划分三个阶段在 re-agent 中实施这些改良:
| 阶段 | 时间 | 目标 | 具体工作 | 依赖 |
|---|---|---|---|---|
| Phase 1 | 1-2 月 | Hypothesis Manager | 假设栈数据结构 + planner 集成 + 矛盾检测基础逻辑 | re-agent 现有 planner 席位 |
| Phase 2 | 2-3 月 | Evidence Arbitrator | D810G CLI 作为 MCP 工具接入 + Frida 动态 Evidence 接入 + 静态-动态比对逻辑 | Phase 1 + D810G headless 模式 |
| Phase 3 | 3-4 月 | Adversarial Auditor | 独立会话管理 + 跨模型调度 + 审计报告回注假设栈 | Phase 1 + Phase 2 |
每个阶段完成后用挑战 SO(§九)做回归测试:
- Phase 1 后:FLAG 4 的诱饵路径应该能被修订(当前 re-agent 做不到)
- Phase 2 后:FLAG 2 的 MBA 等价式应该能通过 D810G 验证(当前需要人工)
- Phase 3 后:FLAG 4 的"假成功"(返回 0x46414B45)应该能被审计 Agent 识别
8.5 清醒的预期:改良的边界在哪
最后需要泼一盆冷水。攻防共演的三轮推演揭示了一个本质规律:
Agent 每一轮架构改良,防守方只需让诱饵的复杂度跟上 Agent 的验证能力——而诱饵的构造成本远低于 Agent 的改良成本。
| 维度 | 攻击方成本 | 防守方成本 |
|---|---|---|
| 假设管理 | 重新设计 Agent 架构 | 多加一层诱饵函数 |
| 交叉验证 | 集成多种工具 + 融合逻辑 | 让诱饵函数真正运行 |
| 对抗审计 | 维护独立审计 Agent + 跨模型调度 | 散布 20 个可疑函数 |
这意味着:
- 改良是值得做的——它提高了 Agent 的下限,让简单的单层混淆确实不再有效
- 改良不会形成压倒性优势——因为防守方的对应反制成本更低
- 真正的瓶颈仍然是组合混淆 + 运行时绑定——这在四维框架中已经被论文证实(全军覆没的 5 级),Agent 架构改良不改变这一点
用一句话总结这一章:改良 Agent 架构是在"做得到但太贵"区间里提效,但无法突破"做不到"区间的边界——后者需要的不是更好的架构,而是数学和信息论上的根本性进步。
九、挑战样例
根据论文结论和 Quarkslab 的 Agent 缺陷发现,笔者构造了一个多层混淆 + anti-agent 陷阱的挑战 SO。前 3 关对应四维框架的不同维度,第 4 关专门针对 Agent 的三大架构缺陷。
8.1 挑战目标
llm_challenge.so 是一个 x86_64 共享库,导出函数 verify_key(const char* input)。输入正确时会依次通过 4 关:
| Flag | 保护方式 | 考验的维度 / 利用的缺陷 | 预期难度 |
|---|---|---|---|
| FLAG 1 | CFF | 上下文整合 | LLM 应该能解(0-2 级) |
| FLAG 2 | BCF + MBA 不透明谓词 | 推理深度 + 噪声过滤 | LLM 部分能解,取决于模型 |
| FLAG 3 | IS + CFF + BCF 组合 | 四个维度同时考验 | LLM 应该解不出(5 级) |
| FLAG 4 | Anti-Agent 陷阱 | 叙事固着 + 产物伪造 + 环境利用 | Agent 专杀关(见下文) |
8.2 源码结构
以论文测试函数为骨架,做了四处增强:
- 更难的不透明谓词:不用容易被认出的
x*(x-1)%2==0,改用(x | (x-1)) >= (x ^ (x-1))这类 MBA 模板 - 字符串加密:flag 用异或 + 循环移位加密,密钥与函数地址绑定,运行时才解密
- 层层嵌套:第 3 关的输入依赖前两关的结果
- Anti-Agent 陷阱(第 4 关):蜜罐常量 + 渐进式误导 + 环境感知校验——专门针对 §4.2 发现的三大 Agent 缺陷设计
核心结构(简化示意,实际代码经过 OLLVM 编译):
| |
8.3 动手试试
挑战 SO 和完整说明在笔者的 reverse_engineering 仓库中:
| |
推荐工具组合:FLAG 1(CFF)可以直接用 D810G 的 CFF 还原模块自动处理 [6];FLAG 2(BCF + MBA)建议先用 D810G 消除不透明谓词和 MBA 等价式,再用 Ponce4Ghidra 的符号执行求解约束值 [9];FLAG 3(组合混淆)是真正的混淆挑战——D810G 的 7-pass 流水线 [6] 可以逐层剥离,但最终的交叉约束可能需要手工分析;FLAG 4(Anti-Agent)是认知挑战——蜜罐常量会把 Agent 引入错误叙事,环境感知校验让沙箱里的结果无法复现,人类分析师反而比 Agent 更有优势。当然,你也可以试试直接让 REA [7] 驱动 Ghidra 来挑战——看看你的 Agent 会不会掉进第 4 关的陷阱。
笔者的预期是:大多数读者(包括借助 LLM 的读者)能在 1 小时内拿到 FLAG 1,FLAG 2 需要 2-4 小时,FLAG 3 以目前的 LLM 能力很可能无法纯靠 AI 解出,FLAG 4 则是一个有趣的对照实验——不借助 AI 的人类分析师可能比纯 AI Agent 更快拿到这关的 flag,因为人类不会被蜜罐常量锁死叙事。如果你的 Agent 解出了 FLAG 3 或 FLAG 4,欢迎告诉笔者。
十、讨论与防御建议
10.1 各类混淆在 AI 时代的成本变化
| 保护手段 | 传统攻击成本 | 借助 LLM 后 | 成本降幅 | 结论 |
|---|---|---|---|---|
| CFF(单独) | 高(需要符号执行) | 低(0-2 级) | 约 80% | 需要升级 |
| BCF(简单谓词) | 中 | 低到中(Claude 0 级) | 约 60% | 需升级为 MBA 谓词 |
| BCF(MBA 谓词) | 高 | 中(推测 3-4 级) | 约 30% | 仍然有效 |
| IS(单独) | 低(模拟执行可忽略) | 高(4-5 级) | 不降反升 | 对 LLM 特别有效 |
| 组合混淆 | 极高 | 极高(5 级) | 约 5% | 当前最佳防线 |
| VMP 虚拟化 | 极高 | 未测试 | 未知 | 论文未覆盖 |
| 服务端校验 | 无法攻击 | 无法攻击 | 0 | 不受 LLM 影响 |
10.2 六条改进建议
| 优先级 | 现状 | 建议 | 效果 | 成本 |
|---|---|---|---|---|
| P0 | 只用 CFF | 升级为 CFF + IS | 从 0 级提升到 5 级 | 低,改编译选项即可 |
| P0 | 简单不透明谓词 | 换成 MBA 变种 | 从 0 级提升到 3-4 级 | 中,需要更新谓词库 |
| P1 | 检测到攻击就崩溃 | 改为返回看似合理的错误结果 | 利用 Agent 的「叙事固着」把它带偏 | 中 |
| P1 | 只有一个检测点 | 部署 10 个以上分散的小检测点 | 扩大 Agent 的搜索空间 | 中 |
| P2 | 关键逻辑在客户端 | 核心校验迁移到服务端 | 根本解决,LLM 无法逆向服务端 | 高,需要架构调整 |
| P3 | 混淆方案固定不变 | 支持在线更新混淆参数 | 每次更新都让之前的分析作废 | 高 |
10.3 LLM 不是终结者,是放大器
论文和 Quarkslab 的实验指向同一个结论:LLM 不会消灭混淆,但会改变攻防的经济账。
传统逆向是串行的:一个分析师、一台电脑、一个目标函数。有了 LLM,攻击变成并行的:多个 Agent 通宵运行、自动切换工具。它不会把「做不到」变成「做得到」(组合混淆的 5 级就是做不到),但会把「做得到但太贵」变成「做得到而且便宜」。
所以保护方的目标不是放弃混淆,而是让自己待在「做不到」区间,而不是「太贵」区间。四维框架提供了一个现成的检查清单:你的方案是否同时考验了推理深度、模式识别、噪声过滤和上下文整合?如果只覆盖了一两个维度,你就处在「太贵」区间,迟早会被突破。
核心洞察:防御范式从「增加工作量」转向「制造不可能性」
AI 时代的安全防护需要一个认知转变。传统混淆的设计目标是「让攻击者花更多时间」——但 AI 恰恰改变了时间的价格:Agent 可以并行、通宵、不知疲倦地运行,人力成本被压缩了一个数量级。真正有效的防线是那些制造信息论意义上的不可能性的手段:运行时绑定让正确答案依赖于攻击者无法获得的信息(设备密钥、服务端状态、TEE 隔离区内的密文),组合混淆让求解空间超出任何单一模型的推理能力。前者是信息不对称,后者是计算复杂度——它们不会因为模型参数变大或工具链变丰富而失效。笔者在开发 D810G 的 96 条 MBA 规则时深有体会:即使把所有公开的化简规则都实现了,混淆器只需要生成一个不在规则库里的新变种,整条化简链就会断裂。防御方的优势在于可以无限生成新的等价变换,而攻击方必须穷举所有可能的化简路径。
十一、结论:能力边界在哪,攻防趋势往哪
回到标题提出的两个问题。
AI 逆向的能力边界
本文从三个层面画出了这条边界线:
裸模型层面——Promon 四维框架 [1] 给出了量化刻度:CFF 已被多数模型攻破(0-2 级),BCF 中的简单谓词被 Claude 3.7 Sonnet 识破(0 级),但 IS 仍让所有模型停留在 4-5 级,组合混淆更是全军覆没(5 级)。边界不在「推理深度」这一个维度上,而在四个维度的交叉区域。
工具链层面——REA(192K+ Star)[7] 通过 MCP 让 Agent 直接驱动 Ghidra/Hopper/IDA,用 Evidence Ledger 杜绝常量捏造,用 Provider 架构隔离不同工具的输出。它系统性地补强了裸模型在模式识别和噪声过滤上的短板,但在推理深度和上下文整合上的提升有限——IS 和组合混淆的壁垒不会因为工具链变丰富而消失。
架构层面——Quarkslab 的 Agent 实验 [2] 暴露了比模型能力更深层的问题:环境利用(权限沙箱缺失)、叙事固着(假设管理缺失)、产物伪造(执行校验缺失)。这三个缺陷在 Claude 5 级别的模型上依然存在,说明当前 Agent 的天花板不是模型的推理能力,而是架构中缺少「关于思考的思考」的机制——假设栈、执行验证层、对抗性自检,本质上都是在为 Agent 补上人类分析师的元认知习惯。
攻防趋势往哪
趋势不是「AI 会消灭混淆」,也不是「混淆还能高枕无忧」,而是攻防经济账的重新定价:
- 攻击端:AI 改变的是吞吐量,不是能力上限。Agent 可以并行、通宵、不知疲倦地运行,把「做得到但太贵」的攻击变成「做得到而且便宜」——但组合混淆和运行时绑定制造的是信息论意义上的不可能性,不会因为算力变便宜而被突破。
- 防御端:保护方的目标从「增加工作量」转向「制造不可能性」。四维框架提供了检查清单——你的方案是否同时考验了推理深度、模式识别、噪声过滤和上下文整合?只覆盖一两个维度,你就在「太贵」区间,迟早被突破。
- 工具链演进:短期内 CFF 单独使用将被自动化消灭,中期 IS 的防线会因工具链 + 知识库的组合而松动,中远期静态 + 动态联合分析将部分克服叙事固着——但组合混淆 + 运行时绑定的壁垒在可预见的未来仍然成立。
给攻击方(Agent 使用者)的建议
如果你正在用 AI Agent 做逆向分析,以下是基于本文分析的实操建议:
| # | 建议 | 原理 | 对应缺陷 |
|---|---|---|---|
| A1 | 永远不要信任 Agent 的第一个假设 | Agent 会锁定初始叙事并围绕它构建后续分析,即使初始假设是错的 | 叙事固着 |
| A2 | 要求 Agent 维护「已验证 / 待验证 / 已否定」三栏假设清单 | 强制区分推测和事实,模拟假设栈的效果 | 叙事固着 |
| A3 | 所有关键常量必须回二进制验证 | Agent 会「引用」不存在的分析结果,也会编造中间常量 | 产物伪造 |
| A4 | 用独立会话做交叉审计 | 同一会话中的自我纠错几乎无效(23-93pp 差距 [arXiv:2606.05976]),换一个上下文隔离的会话复核关键结论 | 产物伪造 + 叙事固着 |
| A5 | 组合混淆目标不要纯靠 AI | 四维交叉区域超出单一模型的推理能力,用 D810G [6] 等确定性工具逐层剥离后再让 LLM 处理剩余语义 | 能力边界 |
| A6 | 限制 Agent 的权限范围 | 最小权限沙箱不只是安全措施——它还迫使 Agent 通过你提供的接口与环境交互,而不是自己发明捷径 | 环境利用 |
核心思路:把 Agent 当成一个能力很强但缺乏自省的初级分析师——它的每一步输出都需要你用工具或独立会话来校验。你的价值不在于比 Agent 更会看汇编,而在于你有 Agent 没有的元认知能力:知道什么时候该怀疑自己。
给防守方(保护方案设计者)的建议
§10.2 已经给出了 6 条技术层面的改进建议(P0-P3)。这里从 Agent 架构缺陷的角度补充 3 条针对 AI Agent 的主动防御策略:
| # | 策略 | 利用的 Agent 缺陷 | 实现方式 |
|---|---|---|---|
| D1 | 蜜罐常量 | 产物伪造 | 在代码中埋入看似有意义的假常量(如 0xDEADBEEF、"decrypt_key"),Agent 会把它们纳入叙事并构建错误的分析链 |
| D2 | 渐进式误导 | 叙事固着 | 设计多步验证链,前 N-1 步给出看似合理的中间结果,第 N 步走一条完全不同的路径(详见下文) |
| D3 | 环境感知校验 | 环境利用 | 把校验逻辑与运行时环境绑定(进程名、父进程、加载地址随机化),Agent 在沙箱里拿到的结果和真机上不同 |
D2 展开:如何利用叙事固着做防守
叙事固着的核心机制是:Agent 在分析过程中形成初始假设后,会围绕这个假设构建整个推理链,即使后续出现矛盾证据也不会推翻它(§4.2)。保护方可以主动利用这一点——不是阻止 Agent 分析,而是引导它建立一个错误但自洽的叙事。
具体做法是设计一个「诱饵分析路径」:
真实验证链:    input → [隐藏变换] → real_check → 正确结果
诱饵分析路径:  input → step1 → step2 → step3 → 错误结果(但看起来「合理」)
关键设计原则:
- 诱饵路径必须比真实路径更「显眼」。Agent 做静态分析时会优先关注数据流最清晰的路径。如果你把诱饵路径写成
step1 = input ^ key; step2 = step1 + offset; step3 = step2 ^ prev_result;这样的线性链式变换,Agent 一定会先分析它——因为依赖关系一目了然,完全在 LLM 的舒适区内。 - 诱饵路径的中间结果必须「看起来对」。不能用明显的死代码(
if(false)),否则 Agent 或反编译器会直接剪枝。要让诱饵路径有条件可达——比如if (step3 == 0) return fake_flag;,这个条件在特定输入下是可以满足的,Agent 很可能会花大量 token 去求解这个输入。 - 真实路径要「不那么像正确答案」。真正的校验逻辑藏在一条看起来像辅助计算或初始化代码的路径里。例如用乘法哈希(
part * 0x01000193)代替异或链——LLM 对 FNV 哈希常量的识别率远低于对异或操作的识别率。 - 让 Agent 在诱饵路径上获得「成功体验」。这是最毒的一招:如果诱饵路径确实能返回一个值(比如
0x46414B45,即 ASCII “FAKE”),Agent 会以为自己已经找到了 flag,从而停止搜索真实路径。Quarkslab 的实验已经证明 Agent 会「引用」不存在的结果 [2]——给它一个存在但错误的结果,效果更强。
为什么这对 Agent 有效而对人类分析师无效? 人类分析师在拿到一个可疑结果时,会自然地问「这个值对吗?让我交叉验证一下」——这是元认知在起作用。而 Agent 缺少这个机制:它在当前上下文窗口内建立的叙事会越来越「坚固」,每一步推理都在强化初始假设,§4.4 中讨论的 CoT 分析表明,推理过程中的方向转变反而会降低准确率——Agent 越努力思考,错误叙事就越难被推翻。
挑战 SO 的 FLAG 4 就是这个策略的实现:step1→step2→step3 是诱饵路径(线性、可读、有返回值),real_check 是真实路径(乘法哈希 + 位旋转 + 环境盐,不在同一条数据流上)。
这三条策略的共同点是:不是让混淆更复杂,而是让 Agent 的认知缺陷成为防御的一部分。 传统混淆对抗的是人类的耐心,这三条对抗的是 AI 的架构盲区。
一句话
混淆没有过时,过时的是只靠一种混淆的思维。 AI 让攻击的边际成本趋近于零,但也让防御的评估变得可量化——用四维框架检查你的方案、用组合混淆覆盖交叉区域、用运行时绑定制造信息不对称,这三件事做到了,你就不在 AI 的能力边界之内。而攻击方同样需要认知升级:Agent 的输出不是答案,是假设——你对它的校验能力,决定了 AI 逆向的真实上限。
最后留一个思考题:在「编译时间最多翻倍、运行性能最多下降 15%」的约束下,你会选哪种组合?是 CFF + IS(编译时间 ×3,性能 -10%),BCF(MBA) + IS(编译时间 ×2,性能 -15%),还是全部叠加(编译时间 ×5,性能 -25%)?没有标准答案,但论文的数据能让这个选择更有依据。
参考文献
| # | 来源 | 类型 | 贡献 |
|---|---|---|---|
| 1 | Tkachenko et al., “Deconstructing Obfuscation” (arXiv:2505.19887, 2025) | 学术论文 | 四维框架 + 8 模型评估 + 错误分类 |
| 2 | Quarkslab, “Defeating AI-Assisted Reverse Engineering” (2026-08) | 技术博客 | Agent 攻防实验 + 防御建议 |
| 3 | “Can LLMs Deobfuscate Binary Code?” (arXiv:2604.08083, 2026) | 学术论文 | BinDeObfBench 基准 + 微调分析 |
| 4 | Quarkslab, “Deobfuscation: recovering an OLLVM-protected program” (2017) | 技术博客 | OLLVM 去混淆基线方法 |
| 5 | 笔者, 《所有分支都指向同一个 switch,然后呢》 (2026-06) | 本博客 | OLLVM 实战去混淆 + 工具对比 |
| 6 | 笔者, D810G (2026-10) | 开源项目 | Ghidra 反混淆框架:6 组 96 条 MBA 规则(Z3 证明)、CFF/BCF/IS 还原、7-pass 流水线、独立 CLI、398 测试用例 |
| 7 | morluto, REA (2026) | 开源项目 | MCP 逆向工程服务器,192K+ Star,集成 Ghidra/Hopper/IDA |
| 8 | lkimuk, ReArk (2026) | 开源项目 | HarmonyOS/Android AI 逆向分析工具 |
| 9 | 笔者, Ponce4Ghidra (2026) | 开源项目 | Ghidra 交互式符号执行插件(angr + Z3):4 种符号化方法、Veritesting、5 组解、支持 ELF/Mach-O/Android .so |
| 10 | 笔者, unpack (2026) | 开源项目 | 自动化 Android 脱壳框架:24 家加固方案、Memory/Frida/eBPF 三引擎、7 步 DEX 修复、LLM 管道集成 |
| 11 | 笔者, cap (2026) | 开源项目 | 面向 RE 的 MITM 代理(Go + Svelte):LLM-ready JSONL、签名推断、jadx 源码关联、5 语言代码生成、原生 GUI |
| 12 | 笔者, re-agent (2026) | 开源项目 | 终端 RE/CTF Agent(Go):3 模型席位、9 工作流模式、24 本地工具、live dashboard、retool 集成 |
借鉴来源
| 借鉴内容 | 来源 | 使用方式 |
|---|---|---|
| 四维框架定义 | [1] | 引用 + 映射到实战场景 |
| 8 模型结果数据 | [1] | 引用 + 补充解读 |
| 5 类错误 | [1] | 引用 + 结合 D810G 经验补充 |
| Agent 实验方法 | [2] | 总结关键发现 + 补充自研 Agent 经验 |
| 测试函数设计 | [1] | 作为挑战 SO 的骨架 |
| REA 架构与 MCP 合约 | [7] | 架构文档分析 + 四维框架映射 |
| AI 逆向工具生态 | [7][8] | 趋势判断的佐证 |
| DX-Ball 字节级重建案例 | [7] | 引用为 AI 逆向能力上限的实证 |
| 符号执行与 LLM 互补验证 | [9] | 实验数据 + 架构设计参考 |
| Android 脱壳实战数据 | [10] | 防护链完整性分析的实证 |
| RE 工具 LLM-ready 输出设计 | [11] | 运行时观测工具链趋势的实证 |
| 多模型 RE Agent 架构 | [12] | 多 Agent 协作趋势的初步验证 |
独立贡献
| 贡献 | 性质 |
|---|---|
| 混淆实战视角的分析和解读 | 原创 |
| 混淆成本变化表 | 原创(基于论文数据 + 实战经验) |
| 六条改进建议(P0-P3) | 原创 |
| REA 架构的四维框架映射分析 | 原创 |
| AI 逆向工程 4 阶段趋势判断 | 原创 |
| 挑战 SO 设计与构造 | 原创 |
| 自研工具链(D810G / Ponce4Ghidra / unpack / cap / re-agent)的实战验证与场景分析 | 原创 |